MLX-Audio:为 Apple Silicon 打造的极速语音 AI 工具箱
你是否曾经想在自己的 MacBook 上跑一个本地语音合成或语音识别模型,结果被 CUDA 依赖、显存不足和慢如蜗牛的推理速度劝退?MLX-Audio 的出现,旨在彻底解决这个问题。它是一个基于苹果 MLX 框架构建的 Python 音频处理库,把文本转语音(TTS)、语音转文本(STT)、语音转语音(STS)、音乐生成、人声分离、降噪等能力统统打包,让开发者在 M 系列芯片上就能获得开箱即用的高效语音分析体验。本文将带你全面了解这个潜力新星。
截至收录:
MLX-Audio stars数:7905
MLX-Audio forks数:719
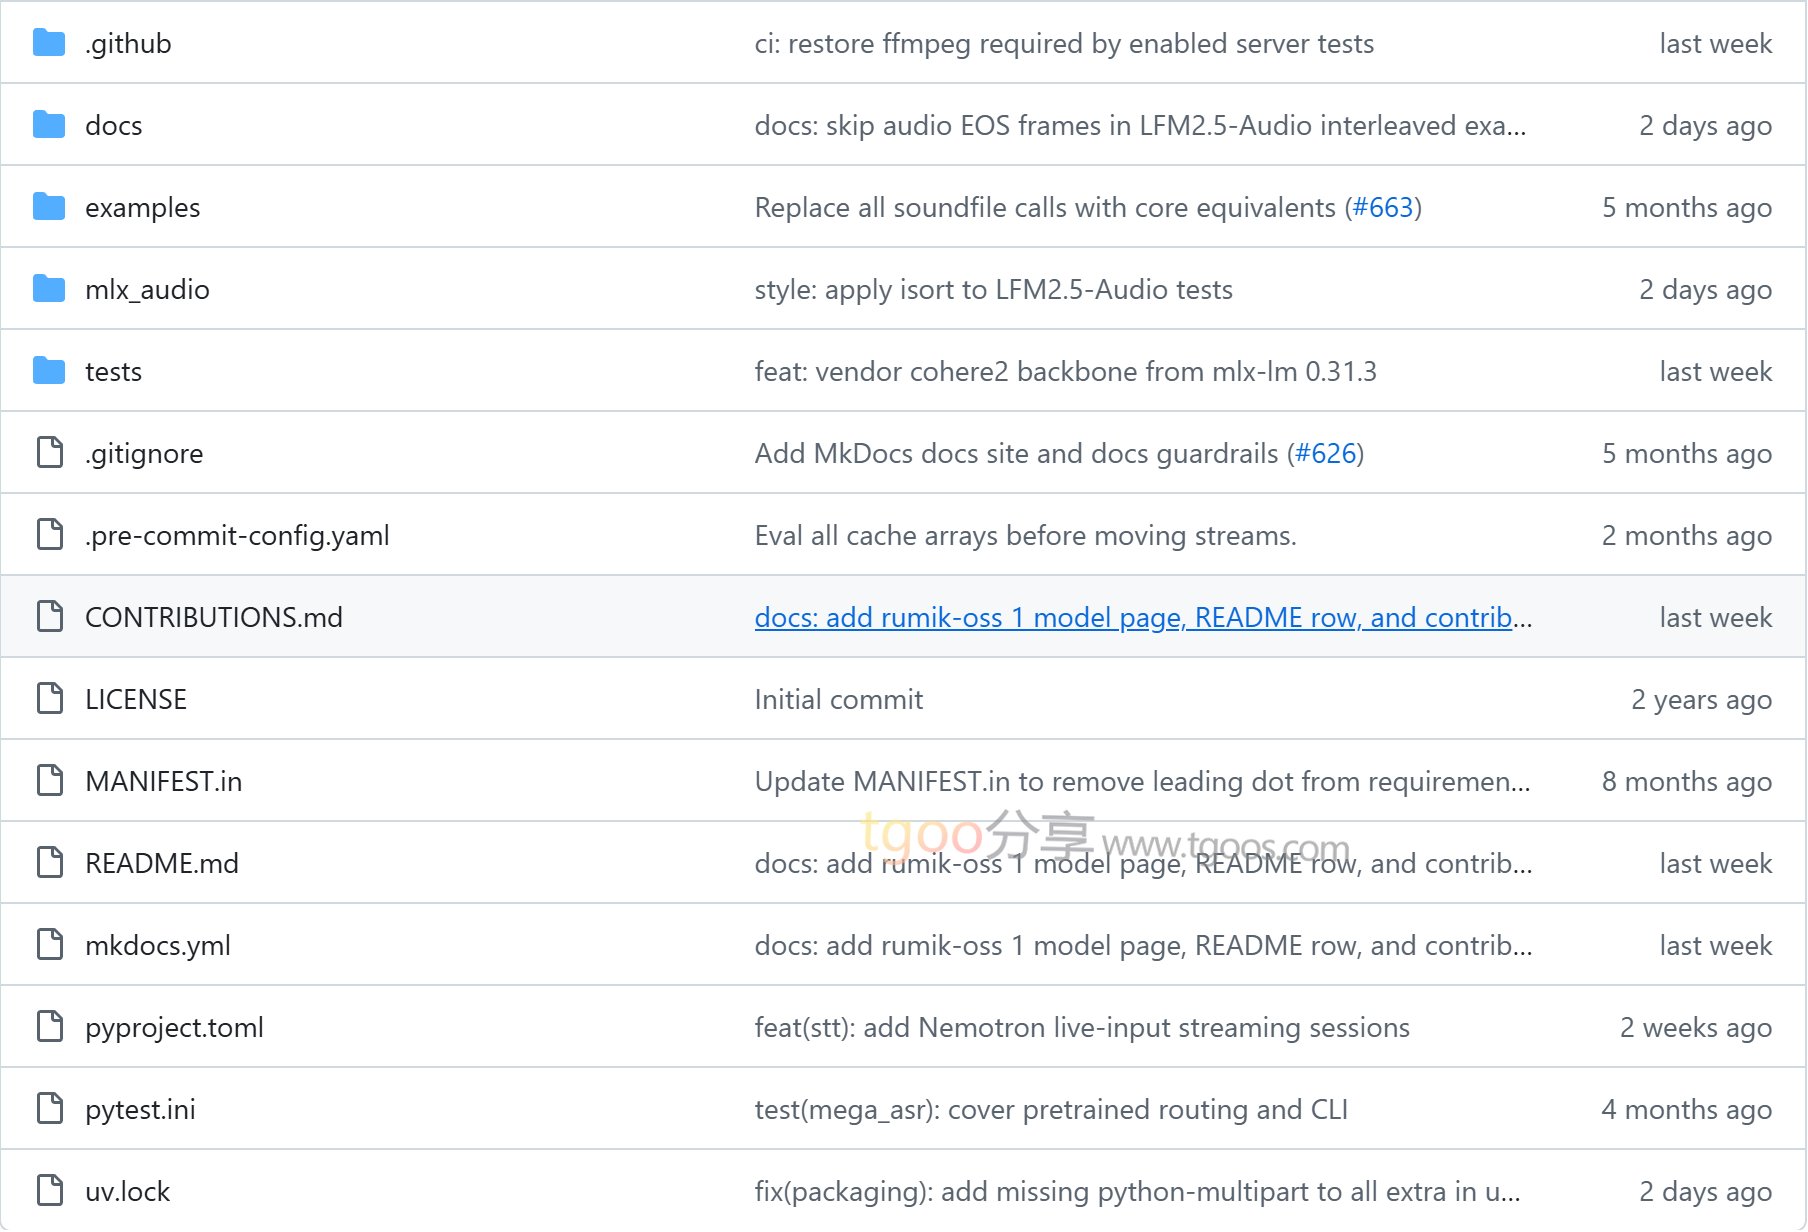
MLX-Audio项目目录截图
MLX-Audio核心亮点
⚡ 亮点一:为 Apple Silicon 原生优化:全部推理路径基于苹果 MLX 框架编写,充分利用 M1/M2/M3/M4 芯片的统一内存架构与 Metal GPU 加速,无需英伟达显卡即可在本地跑起 4B、7B 甚至 16.8B 参数级的语音大模型。
🎙️ 亮点二:全栈式音频能力覆盖:一个库同时搞定多条技术路线——TTS(Kokoro、Qwen3-TTS、Higgs Audio、VoxCPM2、KugelAudio、Voxtral TTS 等)、STT(Whisper、Distil-Whisper、Parakeet、Qwen3-ASR、VibeVoice-ASR、Voxtral Realtime 等)、STS(SAM-Audio 音源分离、MossFormer2 / DeepFilterNet 降噪)、VAD 与说话人分离(Silero VAD、Sortformer),以及音乐生成(MiniMax Music 3),几乎涵盖了音频 AI 的所有主流场景。
🌍 亮点三:多语言与音色克隆:从 Kokoro 的 8 种语言预设音色,到 OmniVoice 覆盖 646+ 语言的零样本克隆,再到 Higgs Audio v3 的百语种对话式合成,多语种内容创作者可以自由选择;配合 --ref_audio 参数,几行代码即可复刻任意参考音色。
🗜️ 亮点四:细粒度量化,内存可大可小:内置 mlx_audio.convert 转换脚本,支持 3-bit、4-bit、6-bit、8-bit 以及 MXFP4 / MXFP8 / NVFP4 等量化模式。同一个模型,你可以根据设备内存与质量需求自由取舍,从 80M 的轻量模型到 16.8B 的大模型都能找到合适的运行姿势。
🖥️ 亮点五:开箱即用的 Web UI 与 OpenAI 兼容 API:内置带 3D 音频可视化的现代 Web 界面,并暴露 /v1/audio/speech、/v1/audio/transcriptions 等 OpenAI 风格端点,现有集成 OpenAI 语音接口的应用只需换个 Base URL 即可无缝迁移。
📱 亮点六:从桌面延伸到移动端:除了 Python 包,官方还提供 Swift 包 mlx-audio-swift,让 iOS / macOS 应用可以在端侧直接调用 TTS 能力,实现真正的离线语音交互。
MLX-Audio快速开始
只需几步,你就能在本地运行起 mlx-audio:
- 安装:
“`bash
使用 pip 安装
$ pip install mlx-audio
或者用 uv 只安装命令行工具(最新版)
$ uv tool install –force mlx-audio –prerelease=allow
如果需要 Web 界面和 API 服务,从源码安装开发依赖
$ git clone https://github.com/Blaizzy/mlx-audio.git
$ cd mlx-audio
$ pip install -e “.[dev, server]”
“` - 运行你的第一条语音合成命令:
“`bash
基础 TTS 生成
$ mlx_audio.tts.generate \
–model mlx-community/Qwen3-TTS-12Hz-0.6B-CustomVoice-8bit \
–text Hello, world! \
–voice Vivian边生成边播放,并指定输出目录
$ mlx_audio.tts.generate \
–model mlx-community/Qwen3-TTS-12Hz-0.6B-CustomVoice-8bit \
–text Welcome to MLX-Audio! \
–voice Ryan –lang_code English \
–play –output_path ./my_audio
“` - 在 Python 中调用:
“`python
from mlx_audio.tts.utils import load_modelmodel = load_model(“mlx-community/Qwen3-TTS-12Hz-0.6B-CustomVoice-8bit”)
for result in model.generate(
“Hello from MLX-Audio!”,
voice=”Vivian”,
lang_code=”English”,
):
print(f”Generated {result.audio.shape[0]} samples”)
# result.audio 即为 mx.array 格式的波形数据
“` - 试试语音识别与 Web 服务:
“`bash
语音转文本
$ python -m mlx_audio.stt.generate \
–model mlx-community/whisper-large-v3-turbo-asr-fp16 \
–audio speech.wav启动 OpenAI 兼容的 API 服务
$ mlx_audio.server –host 0.0.0.0 –port 8000
“`随后即可用标准 OpenAI 风格请求调用:
bash

$ curl -X POST http://localhost:8000/v1/audio/speech \

-H "Content-Type: application/json" \

-d  {"model": "mlx-community/Kokoro-82M-bf16", "input": "Hello!", "voice": "af_heart"}  \

--output speech.wav
小提示:默认情况下多段生成会保存为
audio_000.wav、audio_001.wav等编号文件,加上--join_audio可合并为单个文件;使用--stream流式生成时,再追加--save才能落盘。
MLX-Audio应用场景
场景一:播客与有声内容创作:创作者可以用 Kokoro、Qwen3-TTS 或 Higgs Audio v3 批量生成有声书、短视频旁白和多语言版本内容。借助 --ref_audio 音色克隆能力,还能让同一个虚拟主播在数百期节目中保持音色一致,无需每次都重新录制。
场景二:会议记录与字幕生成:使用 VibeVoice-ASR 或 MOSS-Transcribe-Diarize,可以一次性获得带时间戳和说话人标签的结构化 JSON 转写结果,直接对接会议纪要工具;若追求极致速度,Parakeet v3 支持 25 种欧洲语言的流式识别,能在音频播放的同时实时输出文字。
场景三:音频后期与内容清洗:做播客剪辑时,先用 Silero VAD 切掉静音段,再用 MossFormer2 或 DeepFilterNet 去除背景噪声,最后用 SAM-Audio 通过一句文本描述(如 “A person speaking”)把干声与背景音分离,整套流程全部在本地一条命令内完成。
场景四:实时语音助手与对话式 AI:NemotronLabs VoiceChat 提供全双工语音对话能力,Voxtral Realtime 提供低延迟流式转写,开发者可以基于 MLX-Audio 的 OpenAI 兼容 API 搭建完全离线、数据不出本机的语音助手,尤其适合对隐私敏感的企业内部工具。
场景五:iOS / macOS 端侧应用:借助 mlx-audio-swift,独立开发者可以为 iPhone 或 Mac 应用加入离线朗读、语音笔记转写等功能,不依赖云端 API,也就没有按次计费成本和网络延迟。
场景六:音乐与创意实验:MiniMax Music 3 支持根据歌词生成 44.1kHz 立体声歌曲,配合量化版本,即使在中端配置的 Mac 上也能尝试 AI 音乐创作。
用户案例:目前,Hugging Face 上的 mlx-community 组织已为其转换并托管了大量模型权重,Mistral 的 Voxtral 系列、NVIDIA 的 Parakeet 与 Sortformer、微软的 VibeVoice-ASR、阿里巴巴的 Qwen3-TTS / Qwen3-ASR、IBM 的 Granite Speech、以及 KugelAudio、OpenMOSS 等团队的模型均可通过 MLX-Audio 直接加载运行,形成了围绕 Apple Silicon 语音生态的活跃开源协作圈。
MLX-Audio链接
Blaizzy / mlx-audio项目地址:https://github.com/Blaizzy/mlx-audio
本文地址:https://www.tgoos.com/46333
