Outlines:让大模型在生成时就输出靠谱的结构化数据
你是否曾经被 LLM 返回的 JSON 缺字段、类型不对、枚举值乱编、代码块无法解析所困扰?Outlines 的出现,旨在彻底解决这个问题。它是一个由 .txt 团队开发并维护的 Python 结构化输出库,可以帮助开发者在生成阶段约束大模型输出,让结果严格匹配 Pydantic 模型、JSON Schema、正则表达式或自定义语法。本文将带你全面了解这个潜力新星。
截至收录:
Outlines stars数:15820
Outlines forks数:878
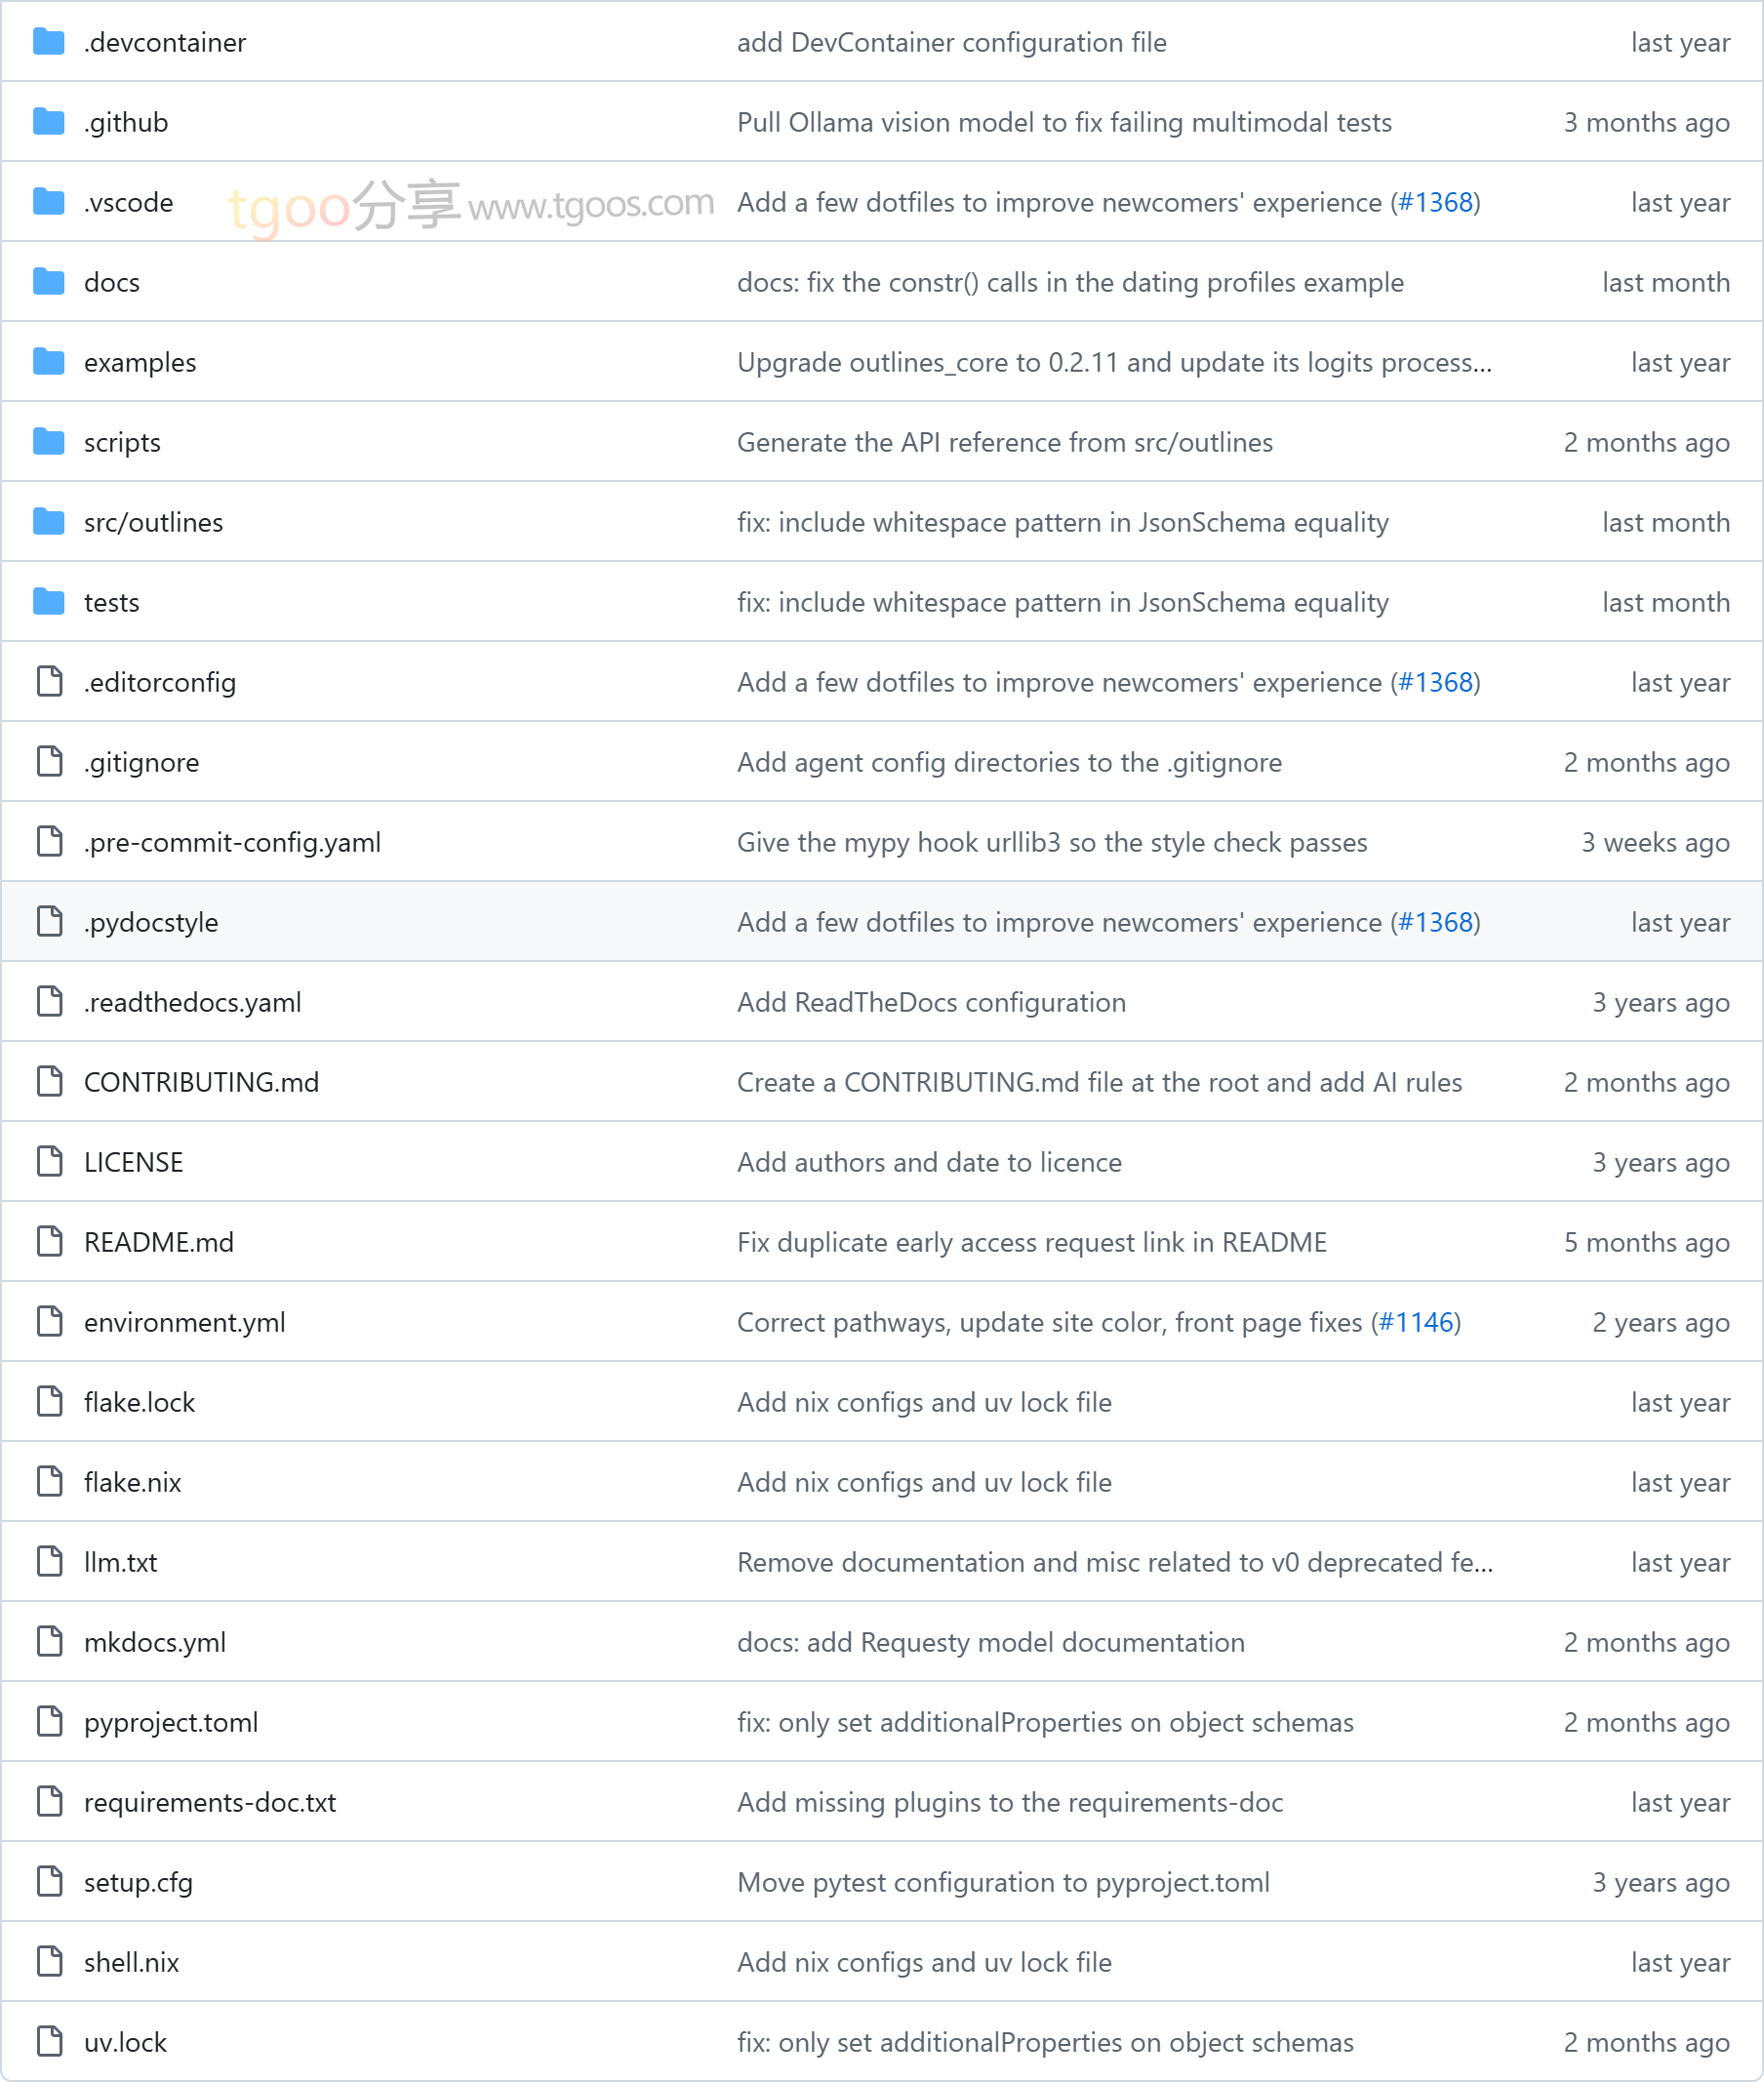
Outlines项目目录截图
Outlines项目核心亮点
🌟 生成时约束,而非事后修补:大多数方案在模型输出后再用正则、解析器或重试来“抢救”数据,Outlines 则直接在解码阶段保证结构有效,从根源上避免破碎 JSON 和无效格式。
🎯 与 Python 类型系统无缝衔接:只需把期望的输出类型传给模型,例如 model(prompt, output_type)。想要是/否答案,用 Literal["Yes", "No"];想要整数,用 int;想要复杂对象,用 Pydantic 模型描述结构。
🧩 一个接口,多模型后端:同一套代码可以运行在 OpenAI、Gemini、vLLM、Ollama、transformers、llama.cpp 等不同模型或推理后端上,方便切换模型而不必重写业务逻辑。
📐 覆盖复杂约束场景:支持多选分类、函数调用、JSON/Pydantic、正则表达式、语法约束等。无论是客服工单分派,还是从自然语言中抽取函数参数,都能得到可验证的结构。
🚀 生产级生态采用:Outlines 已被 NVIDIA、Cohere、HuggingFace、vLLM 等团队信任或集成,适合需要稳定输出、可测试、可维护的 LLM 应用。
📝 模板化提示与可复用应用:通过 Jinja 模板将复杂 Prompt 与代码分离,并可把模板和类型封装成函数或应用,让结构化生成更容易复用和扩展。
Outlines项目快速开始
只需几步,你就能在本地运行起 Outlines:
- 安装:
bash

pip install outlines - 连接你偏好的模型:
“`python
import outlines
from transformers import AutoTokenizer, AutoModelForCausalLMMODEL_NAME = “microsoft/Phi-3-mini-4k-instruct”
model = outlines.from_transformers(
AutoModelForCausalLM.from_pretrained(MODEL_NAME, device_map=”auto”),
AutoTokenizer.from_pretrained(MODEL_NAME)
)
“` - 运行第一个结构化输出:
“`python
from typing import Literalsentiment = model(
“Analyze: This product completely changed my life! “,
Literal[“Positive”, “Negative”, “Neutral”]
)
print(sentiment) # “Positive”temperature = model(“What s the boiling point of water in Celsius?”, int)
print(temperature) # 100
“` - 创建复杂结构:
“`python
from pydantic import BaseModel
from enum import Enumclass Rating(Enum):
poor = 1
fair = 2
good = 3
excellent = 4class ProductReview(BaseModel):
rating: Rating
pros: list[str]
cons: list[str]
summary: strreview = model(
“Review: The XPS 13 has great battery life and a stunning display, but it runs hot and the webcam is poor quality.”,
ProductReview,
max_new_tokens=200,
)review = ProductReview.model_validate_json(review)
print(review.rating.name) # “good”
print(review.pros)
print(review.summary)
“`
Outlines项目应用场景
场景一:客服工单自动分派:将自由格式的客户邮件解析为结构化服务工单,提取优先级、问题类别、是否升级等字段,自动完成路由和分派。
场景二:电商商品分类:从商品描述中抽取主类目、子类目和属性信息,用于库存管理、搜索优化和推荐系统,减少人工分类成本。
场景三:不完整数据解析:解析活动、事件或日程描述,即使信息不完整,也能通过联合类型返回结构化数据或“我不知道”的回退答案,增强提取鲁棒性。
场景四:文档自动归类:把文档分类到预定义类型中,例如“财务报告”“法律合同”“技术文档”,并输出表格和类别分布汇总,方便内容管理。
场景五:函数调用与会议安排:将自然语言请求转换为函数参数,例如会议标题、日期、时长、参会人,再自动调用后端完成会议安排。
场景六:动态 Prompt 模板:使用基于 Jinja 的模板生成动态提示词,支持 few-shot 策略,并在不同内容类型之间复用,同时保持输出结构稳定。
用户案例:目前,NVIDIA、Cohere、HuggingFace、vLLM 等都在使用或集成 Outlines 来改善其 LLM 工作流。
Outlines项目链接
- GitHub 仓库:https://github.com/dottxt-ai/outlines
- 论文引用:Efficient Guided Generation for Large Language Models,arXiv:2307.09702
- 社区入口:可在 GitHub README 中查看 Discord、Issue、贡献指南等链接。dottxt-ai / outlines项目地址:https://github.com/dottxt-ai/outlines本文地址:https://www.tgoos.com/46548
