FreeLLMAPI:把 34 家免费大模型聚合进一个 /v1 端点
你是否曾经为了薅各家大模型的免费额度,被迫维护三十多个 SDK、三十多条速率限制规则,还要在每个 Key 被限流时手忙脚乱地手动切换?FreeLLMAPI 的出现,正是为了彻底解决这个问题。它是一个用 TypeScript 编写的本地优先 LLM 路由网关,可以把市面主流厂商的免费额度聚合成 每月约 74 亿 tokens 的可用推理容量,统一暴露出一个 OpenAI 兼容的 /v1 接口,让你的任何 OpenAI 客户端、编码 Agent 都能透明地跑在自己的免费模型池上。
简单来说:你写代码的方式不变,但背后自动在十几个免费模型之间智能调度。
截至收录:
FreeLLMAPI stars数:26747
FreeLLMAPI forks数:3652
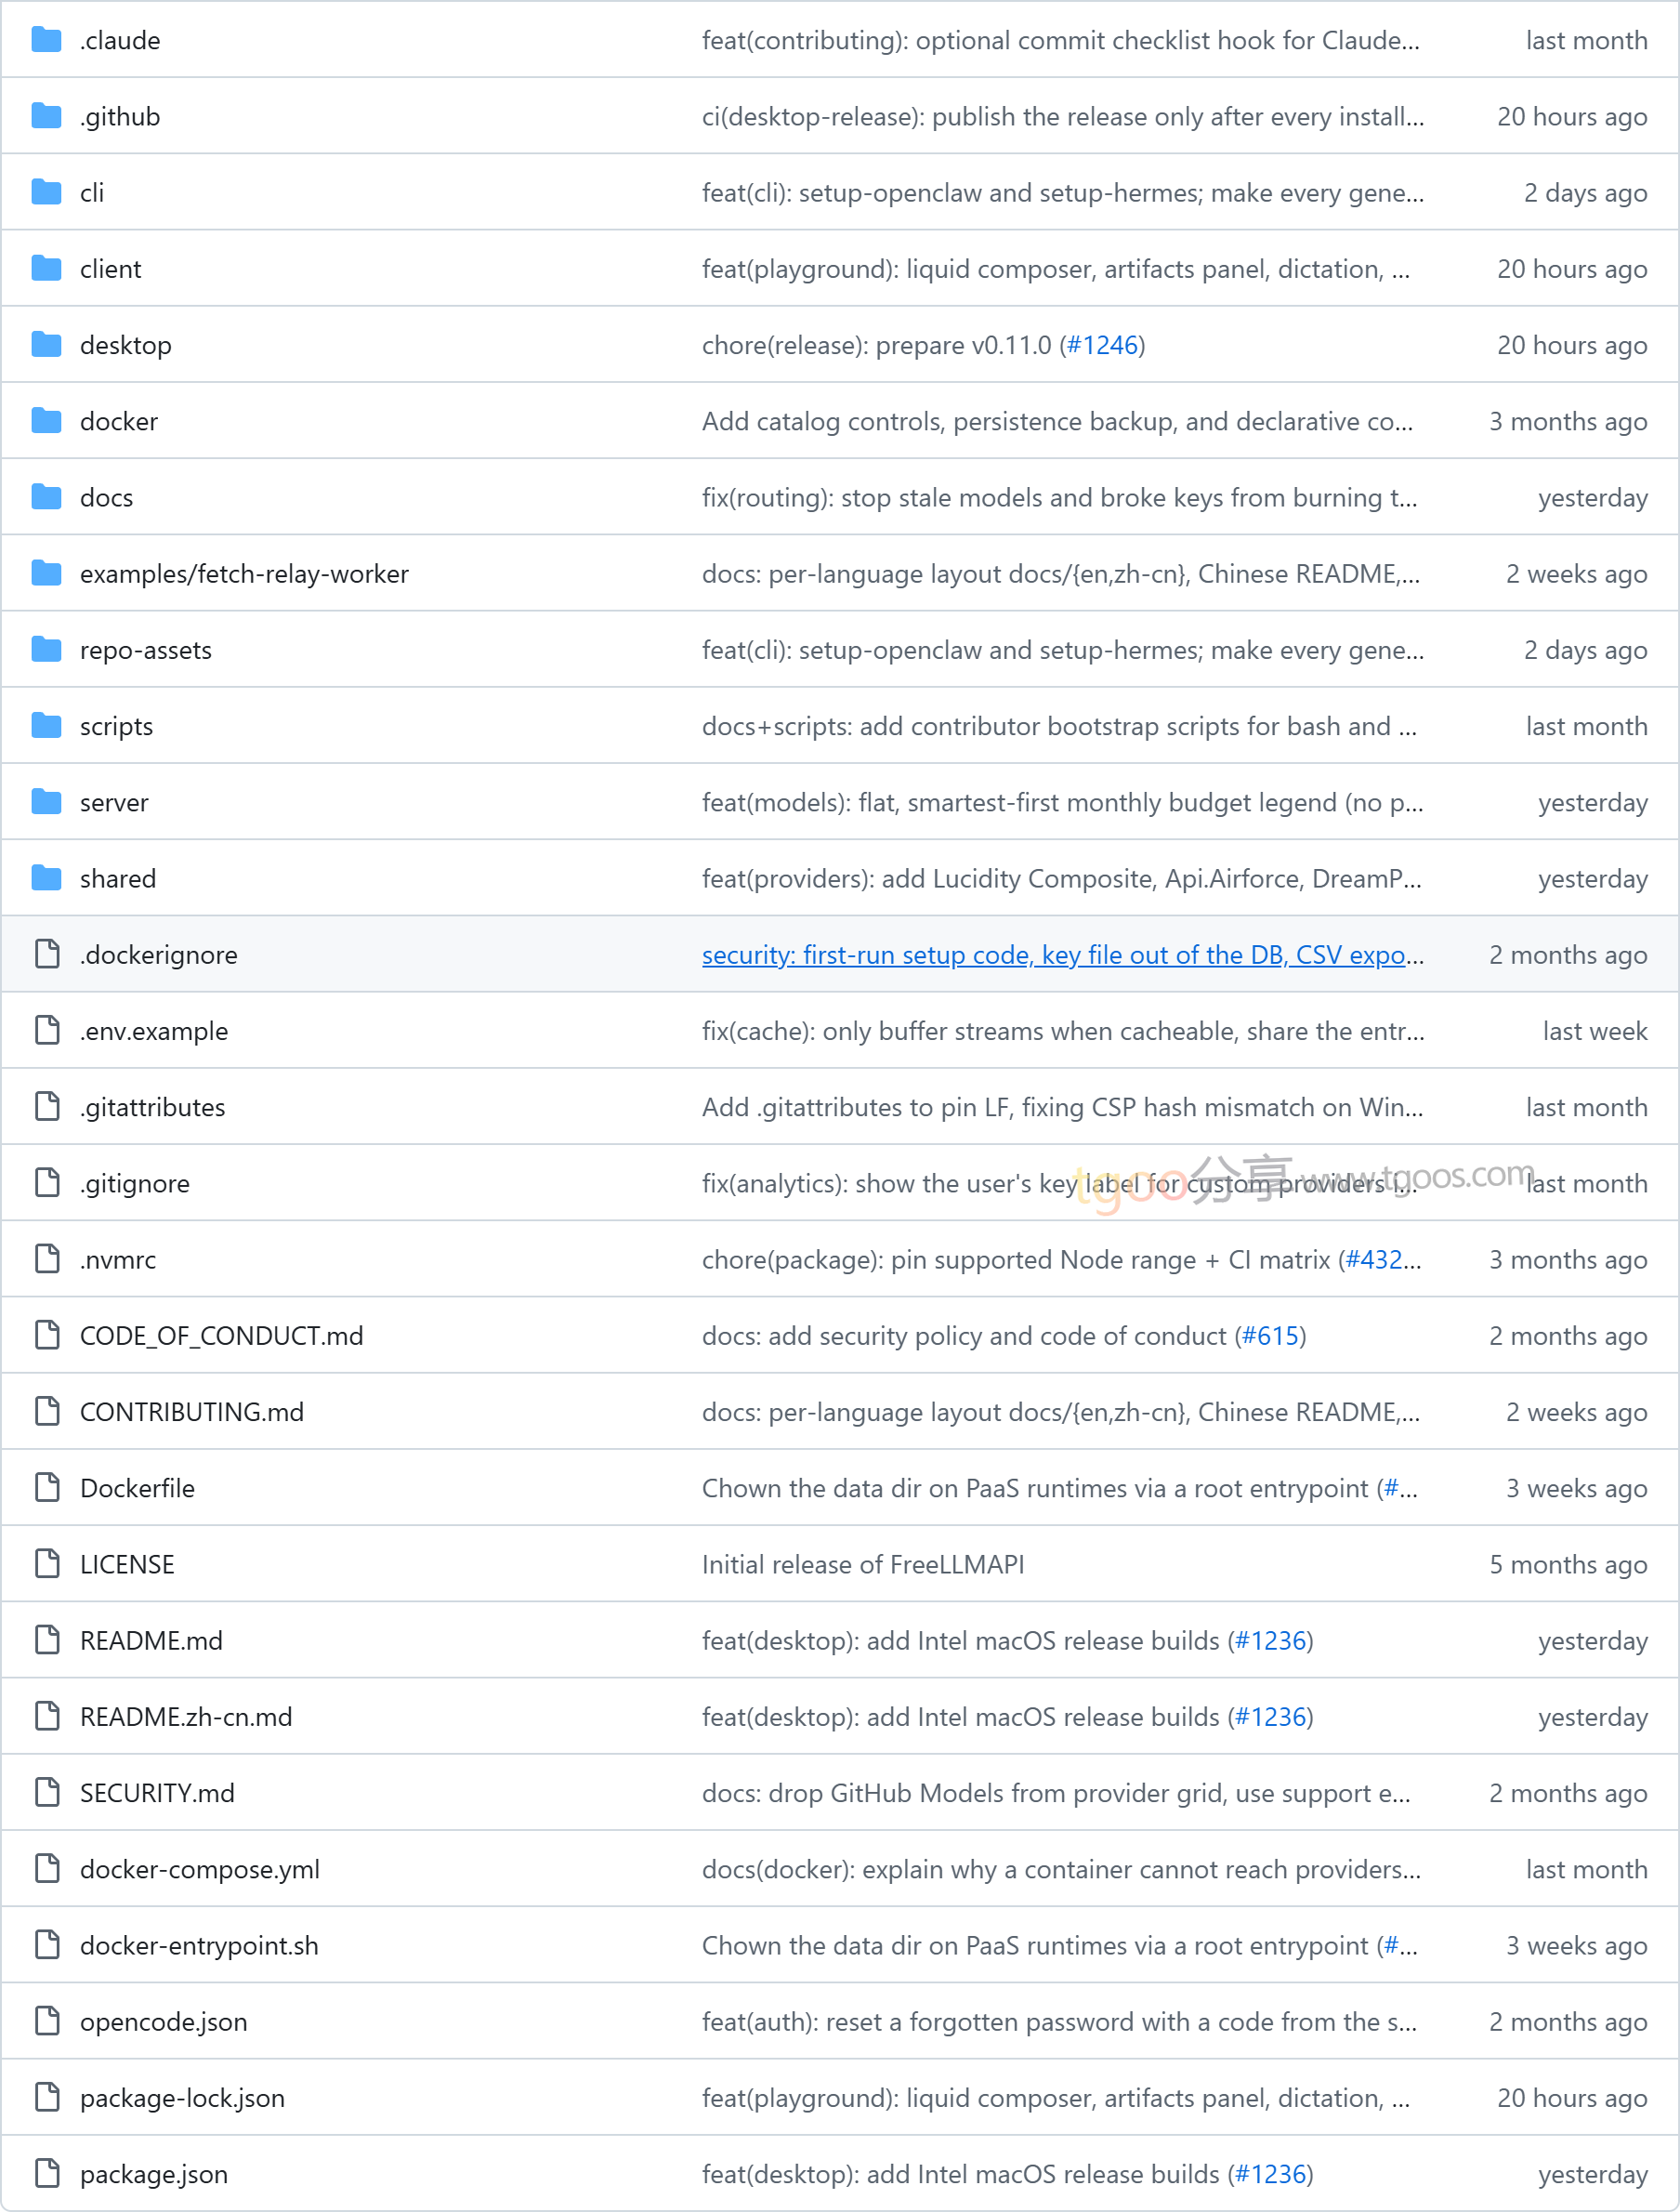
FreeLLMAPI项目目录截图
FreeLLMAPI项目核心亮点
🌐 一池打尽,聚合 34 家免费供应商:Google、Groq、Cerebras、Mistral、OpenRouter、Cloudflare、Cohere、Z.ai、NVIDIA、HuggingFace、ModelScope 等 34 家平台被统一收录,覆盖 474 个模型家族、635 个免费端点(584 个对话、41 个向量、7 个转写、3 个视频)。原本互相割裂的“玩具额度”,叠加起来就变成了真正能干活的推理底座。
🧠 六种智能路由策略 + 自动故障转移:路由器基于每个模型的实时速度、能力和可靠性评分对链路排序,始终挑选“最高优先级、Key 健康、且未触顶限额”的模型。一旦遇到 429 或 5xx,会自动让该 Key 冷却并重试链路上的下一个模型,同时支持 Key 轮换与粘性会话(同一会话 30 分钟内锁定同一模型,切换时还能用“交接摘要”保持上下文连贯)。
🔒 Key 全加密,对外只露一枚令牌:所有供应商密钥在 SQLite 中以 AES-256-GCM 加密存储,仅在请求时于内存中解密;你的应用永远只能看到一个统一的 freellmapi-… Bearer Token。本地优先、单用户设计,请求从你的机器直达上游,中间没有任何第三方看到你的 prompt、补全内容或密钥。
📊 按 Key 级速率追踪,永不越线:为每个 (平台, 模型, Key) 组合维护 RPM/RPD/TPM/TPD 计数器,并动态学习各家供应商实际报告的上限,确保路由决策始终稳稳地待在每条免费额度线之内。
🔄 自更新模型目录:路由器每天两次从签名源(Ed25519 校验)拉取最新模型目录,新模型上线、配额调整、兼容性修复都不需要你 git pull。免费安装跟随“月度快照”,付费版则能当天同步 Live Feed。
🧩 全 OpenAI 风格接口全覆盖 + 多协议兼容:/v1/chat/completions、/v1/responses(Codex CLI 所需)、/v1/completions(编辑器幽灵补全)、/v1/images/generations、/v1/videos/generations、/v1/audio/speech、/v1/audio/transcriptions、/v1/embeddings、/v1/models 一应俱全,同时原生支持 Anthropic Messages 协议(/v1/messages)与 Gemini /v1beta 线格式,还提供可选的 Ollama 仿真层,供 Zed、JetBrains 等客户端接入。
🖥️ 自带仪表盘与桌面应用:React 管理后台支持密钥管理、链路排序、在线 Playground、24h–90d 的 p50/p95/TTFT 分析,界面内置 60 种语言(含 RTL 自动翻转布局)。桌面端还提供菜单栏 App(macOS .dmg / Windows .exe),空闲内存占用仅约 40 MB,Node 20+ 能跑的地方它就能跑——包括树莓派。
FreeLLMAPI项目快速开始
只需几步,你就能在本地运行起 FreeLLMAPI:
- 一行命令安装(需要 Docker):
bash

$ curl -fsSL https://freellmapi.co/install.sh | bash
脚本会创建~/freellmapi目录、生成加密密钥、拉取镜像并启动容器。重复执行是安全的——你的.env与加密密钥会被保留,容器则更新到:latest。 - 打开控制台并配置密钥:
bash

# 浏览器访问 http://localhost:3001

# 在 Keys 页面添加各供应商 Key,并调整 Fallback Chain 顺序

# 从 Keys 页面顶部复制统一 API Key - 用统一 Key 调用 API:
“`python
from openai import OpenAI
client = OpenAI(
base_url=”http://localhost:3001/v1″,
api_key=”freellmapi-your-unified-key”,
)
resp = client.chat.completions.create(
model=”auto”, # 或 “auto:fast” / “auto:smart” / 自定义 profile / 具体模型 ID
messages=[{“role”: “user”, “content”: “用一句话总结罗马的衰亡。”}],
)
print(resp.choices[0].message.content)
print(“Routed via:”, resp.headers.get(“x-routed-via”))
``X-Routed-Via: /` 头,让你清楚知道这次是哪个供应商出的力。
每个响应都会带上
- 一键接入编码 Agent:
bash

$ npx freellmapi setup-claude --url http://localhost:3001 --api-key <unified-key>

# 还支持 setup-codex / setup-cline / setup-aider / setup-continue 等十余种生成器

# 每个生成器都支持 --dry-run,并在修改前自动备份已有配置
FreeLLMAPI项目应用场景
- 编码 Agent 免费加速器:Claude Code、Codex CLI、Cline、Roo Code、Continue、Aider、Goose、Cursor 等主流编码工具都能把 Base URL 指向
http://localhost:3001/v1,用一条npx命令自动完成配置,让日常编码辅助直接跑在免费模型池上。 - 侧项目与原型验证:在正式购买付费 API 之前,用同一套 OpenAI SDK 代码先在 74 亿 tokens 的免费额度里跑通逻辑,产品成形后再无痛切换到付费后端。
- 多模型对比评测:借助
auto:*路由策略与 Fusion 多模型合成模式,同一个 prompt 可以并行分发给多个免费模型,再由裁判模型汇总答案,非常适合做快速的效果横评。 - 本地 / 边缘部署:Node 20+ 即可运行,从 macOS、Windows、Linux 服务器到树莓派 SBC,空闲内存约 40 MB,配合 PM2 / systemd 就能长期常驻。
- 智能体工具链集成:路由器本身还兼作 MCP Server(
/mcp),Agent 可以在会话中途查询当前可用模型、供应商健康状态与路由策略。
⚠️ 重要提醒:项目作者明确声明,FreeLLMAPI 面向个人实验与学习,而非生产环境。免费额度不是稳定、有 SLA 保障的推理基座;如果你要基于它构建真实产品,请在发布前切换为付费 API。同时,各家上游供应商的服务条款在你通过本项目中转流量时依然适用,需自行确保合规。
FreeLLMAPI项目链接
tashfeenahmed / freellmapi项目地址:https://github.com/tashfeenahmed/freellmapi
本文地址:https://www.tgoos.com/46679
