Bonsai-demo:把 270 亿参数的大模型塞进 iPhone,1-bit 量化本地推理开箱即用
你是否曾经被”想在本地跑大模型,却发现动辄需要几十 GB 显存”所困扰?Bonsai-demo 的出现,旨在彻底解决这个问题。它是一个由 PrismML-Eng 开源的 Shell 脚本工具集,可以帮助开发者在 Mac、Linux、Windows 甚至纯 CPU 环境上,用两条命令跑起 1-bit 与三值(Ternary)量化的大语言模型——包括支持视觉、工具调用与思考模式的 27B 旗舰模型。本文将带你全面了解这个潜力新星。
截至收录:
Bonsai-demo 项目 stars 数:2294
Bonsai-demo 项目 forks 数:244
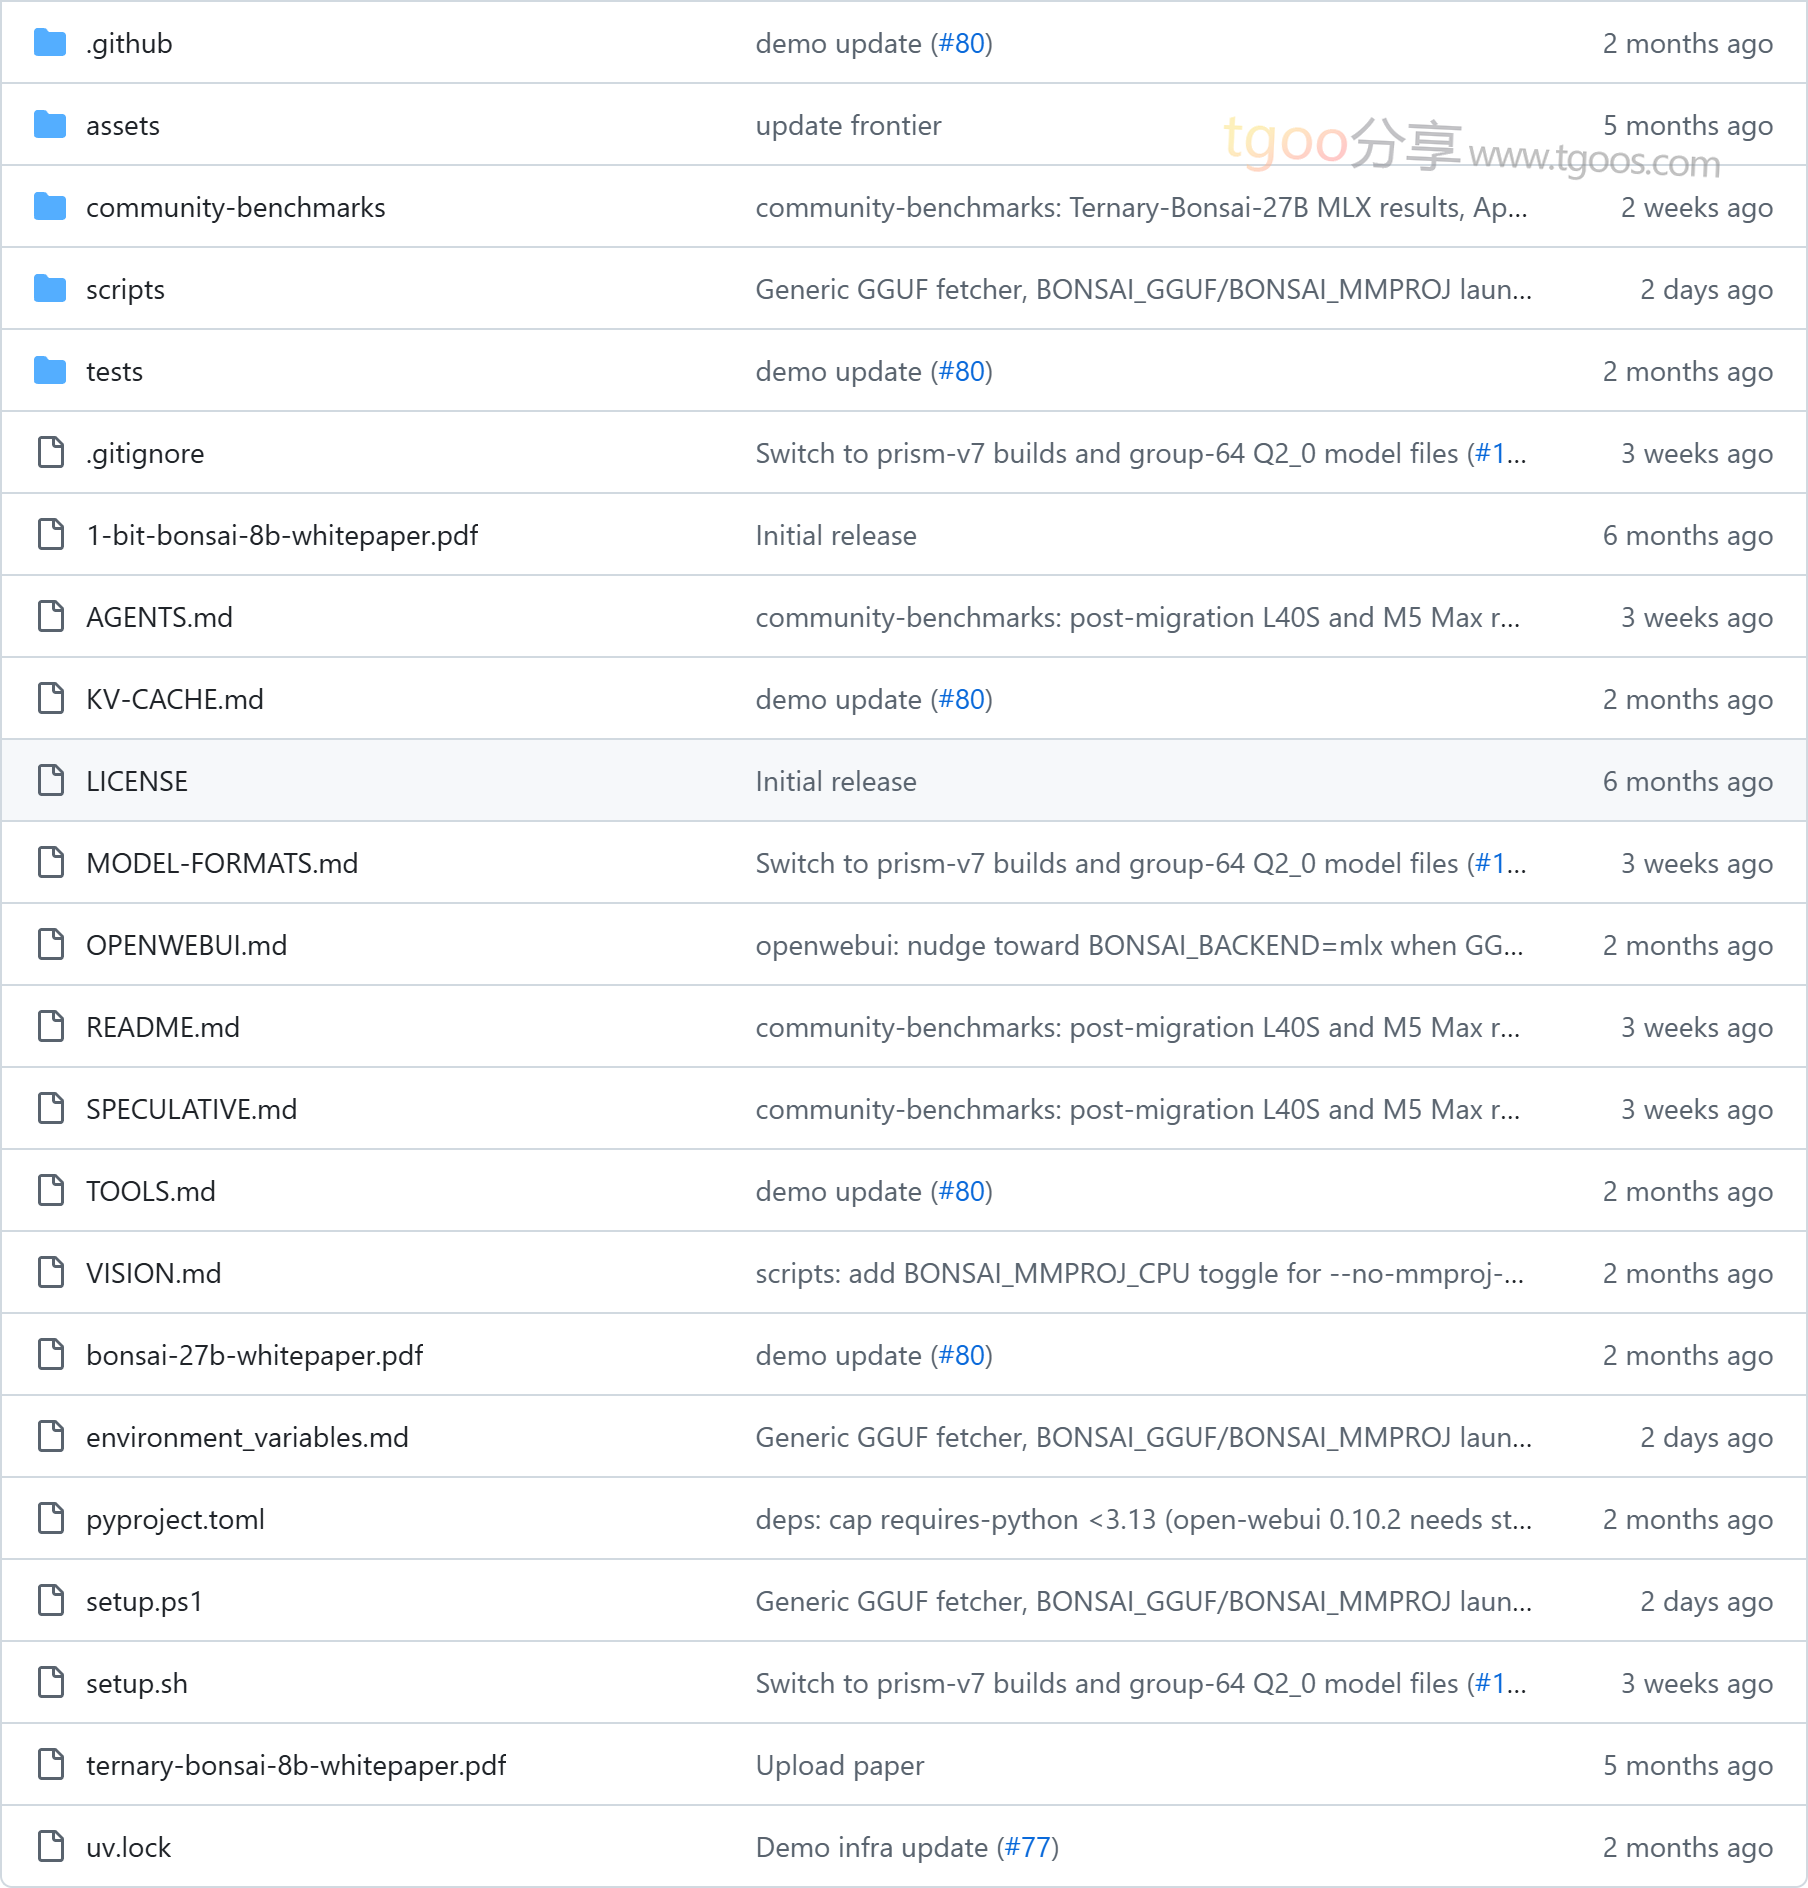
Bonsai-demo 项目目录截图
Bonsai-demo 项目核心亮点
🌟 极致压缩:1.125 bit/权重,27B 模型仅 3.53 GiB
Bonsai 家族提供两条量化路线:Bonsai(1-bit) 采用 Q1_0 格式,把每个权重压到约 1.125 bit,27B 模型的 GGUF 权重只有 3.53 GiB;Ternary-Bonsai 则约为 1.7 bit/权重(打包为 2-bit 以适配快速加速内核),权重约 6.66 GiB,是质量更高的默认选项。作为对比,同规模的 16-bit BF16 模型需要 47.73 GiB,常见的”4-bit”版本也要 15.73 GiB。官方明确表示:1-bit 的 Bonsai-27B 可以直接装进一台现代 iPhone,无需内存卸载技术。
🖼️ 多模态原生:27B 是视觉语言模型
最新的 Bonsai 27B 是该家族首个视觉语言模型。你可以在聊天界面直接上传照片、截图乃至 PDF 并向模型提问,也可以通过 API 发送 image_url 内容块。启动脚本会自动加载视觉投影器,并在较慢的后端上自动降采样超大图片。
🛠️ 完整的 Agentic 能力:原生工具调用 + MCP
27B 支持 OpenAI 风格的原生 tool_calls,具备完整的往返(round-trip)能力;两个官方 Demo 界面都内置了 MCP 客户端,预配置了 Hugging Face 与 DeepWiki 服务,按对话粒度选择性开启,未启用时不产生任何提示词成本。
🧠 会思考的推理模型:可调推理强度
27B 是一个 thinking 模型,默认开启思考。在聊天界面点击输入框里的灯泡图标,就能按会话切换推理强度:Off、Low(512 tokens)、Medium(2048)、High(8192)到 Max(不限制)。选择结果按浏览器持久化,并随每次请求发送——在慢速硬件上,这是最有效的提速手段。
📏 超长上下文:256K+ token 对话
27B 模型最高支持 262,144 tokens 上下文。得益于混合注意力机制,其 KV Cache 相比同规模模型更小——即使不量化,100K 上下文也只需约 6.3 GiB;开启可选的 4-bit KV Cache 后,每 token 开销从 64 KiB 降到约 18 KiB,100K 上下文的 KV Cache 仅约 1.8 GiB。
⚡ 推测解码加速:解码速度最高 2.4 倍
实验性的 dspark 草稿模型搭配可让 27B 提速:在 L40S(CUDA)上实测,三值 27B 的解码速度提升 1.8–2.4 倍,1-bit 版本提升 1.4–1.75 倍(代码与数学任务收益最高)。Apple Silicon 上仅对三值代码/数学任务约 1.2 倍,其他场景反而变慢,因此 Mac 上建议保持关闭。
🌍 全平台覆盖 + 上游合并
支持 macOS(Metal,含 Apple Silicon 与 Intel)、Linux / Windows(CUDA、Vulkan、ROCm / HIP)以及纯 CPU 推理。更重要的是,这套量化格式已经深度合入主线 llama.cpp:Q1_0(1-bit)完全上游合并,Q2_0(三值)的 CPU、Metal、Vulkan、CUDA 后端也陆续并入主线,无需依赖分支即可使用。
Bonsai-demo 快速开始
只需几步,你就能在本地运行起 Bonsai-demo:
- 安装(macOS / Linux):
“`bash
git clone https://github.com/PrismML-Eng/Bonsai-demo.git
cd Bonsai-demo(可选)选择模型尺寸:27B(默认)、8B、4B 或 1.7B
export BONSAI_MODEL=27B
一条命令搞定:安装依赖、下载模型与二进制文件
./setup.sh
“` - Windows(PowerShell):
“`powershell
git clone https://github.com/PrismML-Eng/Bonsai-demo.git
cd Bonsai-demo$env:BONSAI_MODEL = “27B”
Set-ExecutionPolicy -Scope Process -ExecutionPolicy Bypass
.\setup.ps1
“` - 启动聊天服务器:
bash

./scripts/start_llama_server.sh # 打开 http://localhost:8080 - 或者直接跑一条推理命令:
bash

./scripts/run_llama.sh -p "What is the capital of France?"

BONSAI_MODEL=4B ./scripts/run_llama.sh -p "Write a haiku about bonsai trees"
setup.sh 会替你处理好一切:检查并安装系统依赖(macOS 的 Xcode CLT、Linux 的 build-essential)、安装 uv 包管理器、创建 Python 虚拟环境、从 HuggingFace 下载模型(全部公开,无需 token)、从 GitHub Release 拉取预编译二进制,并在 macOS 上从源码构建 MLX。重复执行是安全的,已完成的步骤会自动跳过。
Bonsai-demo 环境变量速查
所有启动脚本都通过环境变量配置,最有用的几个:
| 变量 | 默认值 | 可选值 | 用途 |
|---|---|---|---|
BONSAI_MODEL |
27B |
27B / 8B / 4B / 1.7B | 模型尺寸 |
BONSAI_FAMILY |
ternary |
ternary / bonsai | 模型家族(三值 / 1-bit) |
BONSAI_NGL |
自动检测 | 整数;0 = 纯 CPU | GPU 层卸载数量 |
BONSAI_CTX |
自动(按内存分档) | 0 或 ≤ 262144 | 上下文长度 |
BONSAI_SPECULATIVE |
0 |
1 | 启用 dspark 推测解码 |
BONSAI_KV4 |
0 |
1 | 长上下文用 4-bit KV Cache |
可以自由组合:
./setup.sh                                       # 默认 Ternary-Bonsai-27B
BONSAI_FAMILY=bonsai BONSAI_MODEL=4B ./setup.sh  # 1-bit 的 Bonsai-4B
BONSAI_MODEL=all ./setup.sh                      # 全部 4 种三值尺寸
Bonsai-demo 应用场景
场景一:消费级设备上的私有 AI 助手 在没有独立显卡的笔记本、甚至手机上,用 1-bit Bonsai-27B 搭建一个完全离线的对话助手。权重只占 3.5 GiB,4K 上下文下总内存约 4.8 GiB,对现代设备极为友好。
场景二:视觉文档理解与 OCR 把截图、发票、PDF 直接丢给 27B 视觉模型提问,在本地完成文档问答、图表解读与文字提取,敏感数据不出本机。
场景三:带工具调用的智能体开发 借助原生 tool_calls 和内置 MCP 客户端,把本地模型接入外部工具链——比如让模型查询最新网页资料、调用代码解释器绘图、或访问内部的销售数据库做数据探查。
场景四:端到端 Agentic Demo 演示 可选的 Open WebUI 集成(./scripts/start_openwebui.sh)会一键拉起一个类 ChatGPT 界面,自动配置好服务端代码解释器(matplotlib / pandas / numpy / scipy / sympy / yfinance)和一个用于调查”隐藏故事”的销售演示数据库,开箱即可演示完整的智能体工作流。
场景五:量化研究与小模型基准测试 community-benchmarks/ 目录汇总了不同硬件上的社区测试结果,并提供提交模板,方便研究者对比 1-bit 与三值量化在各后端的实际表现。
用户案例:目前,Bonsai 系列模型的量化格式已被 主线 llama.cpp 全面接纳——Q1_0 完全上游合并,Q2_0 的 CPU、Metal、Vulkan、CUDA 后端陆续并入(见 ggml-org/llama.cpp 的 #24448、#25419、#25430、#25707 等 PR),MLX 侧也提交了 1-bit 量化支持的上游 PR。这套方案正被越来越多的本地推理项目参考与采用。
27B 模型内存占用参考
| 模型 | 格式 | 权重 | 4K 上下文 | 10K 上下文 | 100K 上下文 |
|---|---|---|---|---|---|
| Bonsai-27B(1-bit) | llama.cpp Q1_0 | 3.53 GiB | 4.8 GiB | 5.2 GiB | 10.8 GiB |
| Bonsai-27B(1-bit) | MLX 1-bit | 3.92 GiB | 5.5 GiB | 5.9 GiB | 11.4 GiB |
| Ternary-Bonsai-27B | llama.cpp Q2_0 | 6.66 GiB | 7.8 GiB | 8.1 GiB | 13.7 GiB |
| Ternary-Bonsai-27B | MLX 2-bit | 7.05 GiB | 8.6 GiB | 8.9 GiB | 14.4 GiB |
| 参考:27B 16-bit | GGUF BF16 | 47.73 GiB | 49 GiB | 49.6 GiB | 55.2 GiB |
| 参考:27B “4-bit” | UD Q4_K_M | 15.73 GiB | 17.2 GiB | 17.6 GiB | 23.2 GiB |
启动脚本会根据机器内存自动分档选择默认上下文,从小内存机器的 8K 一直到 71 GB 以上机器的 131K,让内存占用始终可预期。
Bonsai-demo 链接
PrismML-Eng / Bonsai-demo项目地址:https://github.com/PrismML-Eng/Bonsai-demo
本文地址:https://www.tgoos.com/46483
