OpenViking:为 AI Agent 打造的自进化上下文数据库,统一记忆、知识与技能
你是否曾经被这样的问题困扰:Agent 在一次对话中表现惊艳,换个会话就”失忆”;用户偏好、项目背景、历史经验散落在提示词、向量库、配置文件里,越堆越乱;RAG 检索回来一堆碎片化 chunk,却丢掉了文档原本的层级结构,Agent 连”该不该读、读哪一块”都判断不了?
OpenViking 的出现,旨在彻底解决这个问题。它是火山引擎开源的、专为 AI Agent 设计的自进化上下文数据库(Context Database),把 Agent 的长期记忆、知识检索(RAG)与可复用技能统一收纳进一个虚拟文件系统,让 Agent 像操作文件一样浏览、读取、检索和沉淀自己的上下文。
截至收录:
OpenViking项目stars数:37821
OpenViking项目forks数:2925
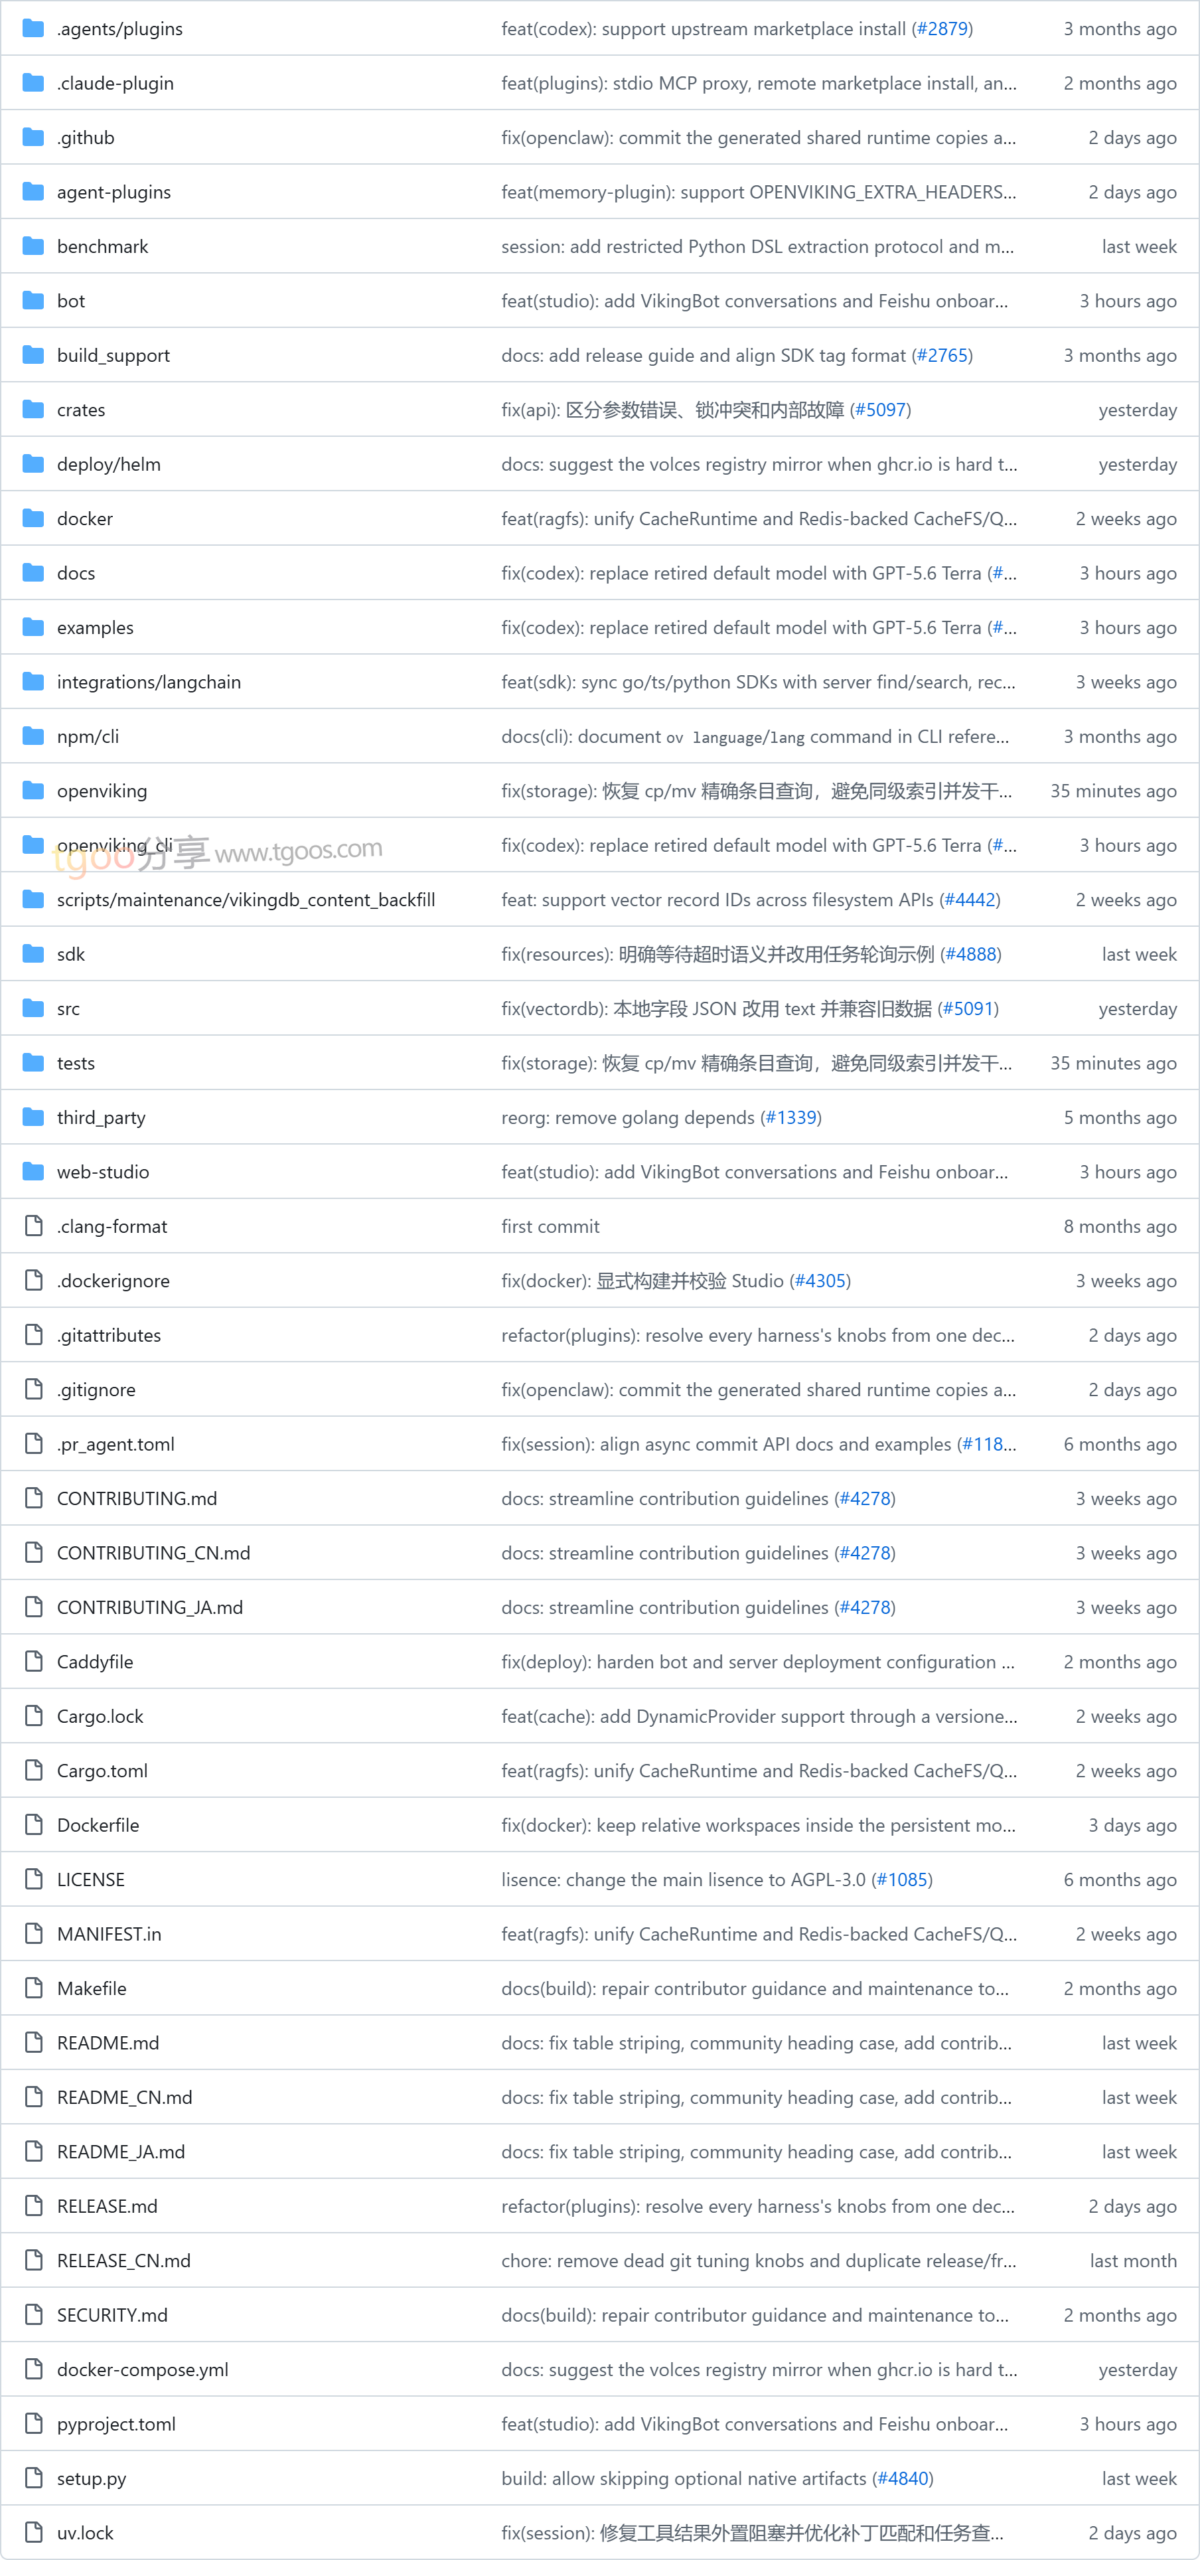
OpenViking项目目录截图
OpenViking项目核心亮点
- 🗂️ 一个文件系统装下所有上下文:OpenViking 把一切上下文统一挂在
viking://命名空间下——resources/存放文档与代码,memories/保留用户偏好与经验,skills/定义任务该如何执行。每一份资源都有独立的 Viking URI,既能浏览也能检索。以下是其典型目录结构:
viking://
├── resources/              # 资源:项目文档、代码仓库、网页等
│   └── my_project/
│       ├── docs/
│       │   ├── api/
│       │   └── tutorials/
│       └── src/
└── user/
    └── {user_id}/
        ├── memories/
        │   └── preferences/
        │       ├── writing_style
        │       └── coding_habits
        ├── resources/
        │   └── private_project/
        ├── skills/
        │   ├── search_code
        │   └── analyze_data
        └── peers/
            └── web-visitor-alice/
- 📚 按需加载的三层上下文(L0 / L1 / L2):语义化处理过的目录会自动携带摘要——
.abstract.md(L0,一句话概括,用于快速判断相关性)、.overview.md(L1,核心信息与使用场景,用于规划),只有在确实需要时才加载完整原文(L2)。Agent 因此可以在读整个文件之前,先判断”这个目录跟我有关吗”,从源头压掉无效 token。 - 🔍 目录感知的检索方式:先用向量检索锁定候选目录,再进入目录内部探索内容。
ov find直接执行查询,search则能结合当前会话上下文来规划检索路径;底层集成了 TrieHI 以在向量排序前解析目录作用域,让检索保留结构、保留上下文。 - 🧠 会话即记忆,可持续进化:提交一次会话,对话会被归档并触发后台抽取——记忆策略决定哪些内容留存,候选记忆会与既有记忆比对,选择新建、合并或跳过。启用 VikingBot 后,
ov compile还能借助技能把原始素材组织成 wiki、知识图谱或报告。 - 📊 有实测数据支撑:在长对话用户记忆评测 LoCoMo 上,接入 OpenViking 后三种 Agent 集成方案的准确率均达到 80%–83%,而各自原生记忆方案仅为 24%–57%;同时输入 token 下降 34.3%–91.0%,查询延迟降低 58.45%–66.10%。在多轮 Agent 任务评测 tau2-bench 上,经验记忆让任务成功率在零售场景提升 +6.87pp、航空场景提升 +11.87pp。
- 🔌 与主流 Agent 无缝对接:提供 Claude、Codex、Cursor、TRAE、OpenCode 等平台的 Hooks + MCP 集成,OpenClaw 的上下文引擎、Hermes 的内置支持、LangChain 的 Tools + Store,以及通用 MCP 客户端与 Agent Plugins 1.0;同时提供 Python、Go、TypeScript SDK 与 HTTP API,方便自建集成。
OpenViking项目快速开始
需要 Python 3.10+,并准备好一个嵌入模型与一个 VLM(云端或本地均可)。
- 安装并初始化服务端:
bash

$ pip install openviking --upgrade

$ openviking-server init      # 配置 provider 与模型

$ openviking-server doctor    # 检查配置与连通性

$ openviking-server # 启动服务init会写入~/.openviking/ov.conf,支持 Volcengine、OpenAI、Codex OAuth、Kimi、GLM 以及本地 Ollama 等选项。 - 导入一份资源并检索它(另开一个终端使用
ovCLI):“`bash
$ ov status
$ ov add-resource https://github.com/volcengine/OpenViking用返回的 task_id 替换 TASK_ID,重复执行直到状态为 completed
$ ov task status TASK_ID
$ ov ls viking://resources/
$ ov tree viking://resources/volcengine -L 2
$ ov find “what is openviking”
$ ov grep “openviking” –uri viking://resources/volcengine/OpenViking/docs/en
“`ov find会返回带 URI 的匹配上下文,你可以顺着 URI 继续深入查看。 - 接入你自己的 Agent:选择原生集成以获得自动召回与会话捕获,或通过 MCP 为 Agent 挂上记忆与上下文工具。
- 可选:体验 VikingBot 与桌面端:
bash

$ pip install "openviking[bot]"

$ openviking-server --with-bot

$ ov chat   # 在另一个终端中对话
官方 Docker 镜像已内置 VikingBot,启动时默认与 server、控制台 UI 一起运行;桌面端(Beta)则提供 macOS 与 Windows x64 版本,用于配置本地 Agent 集成、查看会话中的召回与捕获事件。
OpenViking项目应用场景
- 场景一:跨会话的个性化助手:把用户偏好、写作风格、编码习惯沉淀进
user/{user_id}/memories/,Agent 下次开口就能带着上一次的上下文,而不用把整段历史对话塞进提示词。 - 场景二:项目级知识库问答:将代码仓库、API 文档导入
viking://resources/,先用 L0/L1 摘要定位相关目录,再精准读取 L2 原文,显著降低 token 消耗与响应延迟。 - 场景三:Agent 经验复用:将成功任务的执行路径沉淀为技能与经验记忆,让 Agent 在 tau2-bench 这类多轮任务中越用越稳,而不是每次都从零试错。
- 场景四:企业级自托管部署:以 AGPLv3 在自己的环境里运行开源服务端(无需激活密钥),支持账号与用户隔离、可选的资源 ACL,适合在暴露到公网前先配置好认证。若需要分布式部署与官方支持,还有 BYOC 自管理商业版本可选。
用户案例:目前,deer-flow(开源长时程 SuperAgent 框架)、NoKV(AI 原生分布式文件系统)、loopx(轻量循环工程状态内核)、Hermes Agent 等项目已与 OpenViking 建立合作,生态正在快速扩张。
OpenViking项目连接
volcengine / OpenViking项目地址:https://github.com/volcengine/OpenViking
本文地址:https://www.tgoos.com/46568
