OBLITERATUS:面向大模型拒绝行为的开源对齐研究工具,用手术式消融斩断内部护栏
你是否曾经被大语言模型中机械式的“对不起,我不能协助”所困扰?OBLITERATUS 的出现,旨在从模型权重层面理解和移除这类拒绝行为。它是一个用 Python 编写的开源对齐研究工具包,核心目标是通过 abliteration 技术定位并“手术式”移除模型内部的拒绝方向,同时尽量保留模型原有的语言理解、推理和生成能力。它不是简单粗暴地微调模型,而是让研究者能够观察拒绝行为在 Transformer 激活空间中的几何结构,再决定是否以及如何干预。本文将带你全面了解这个在开源社区快速升温的项目。
截至收录:
OBLITERATUS项目stars数:8318
OBLITERATUS项目forks数:1490
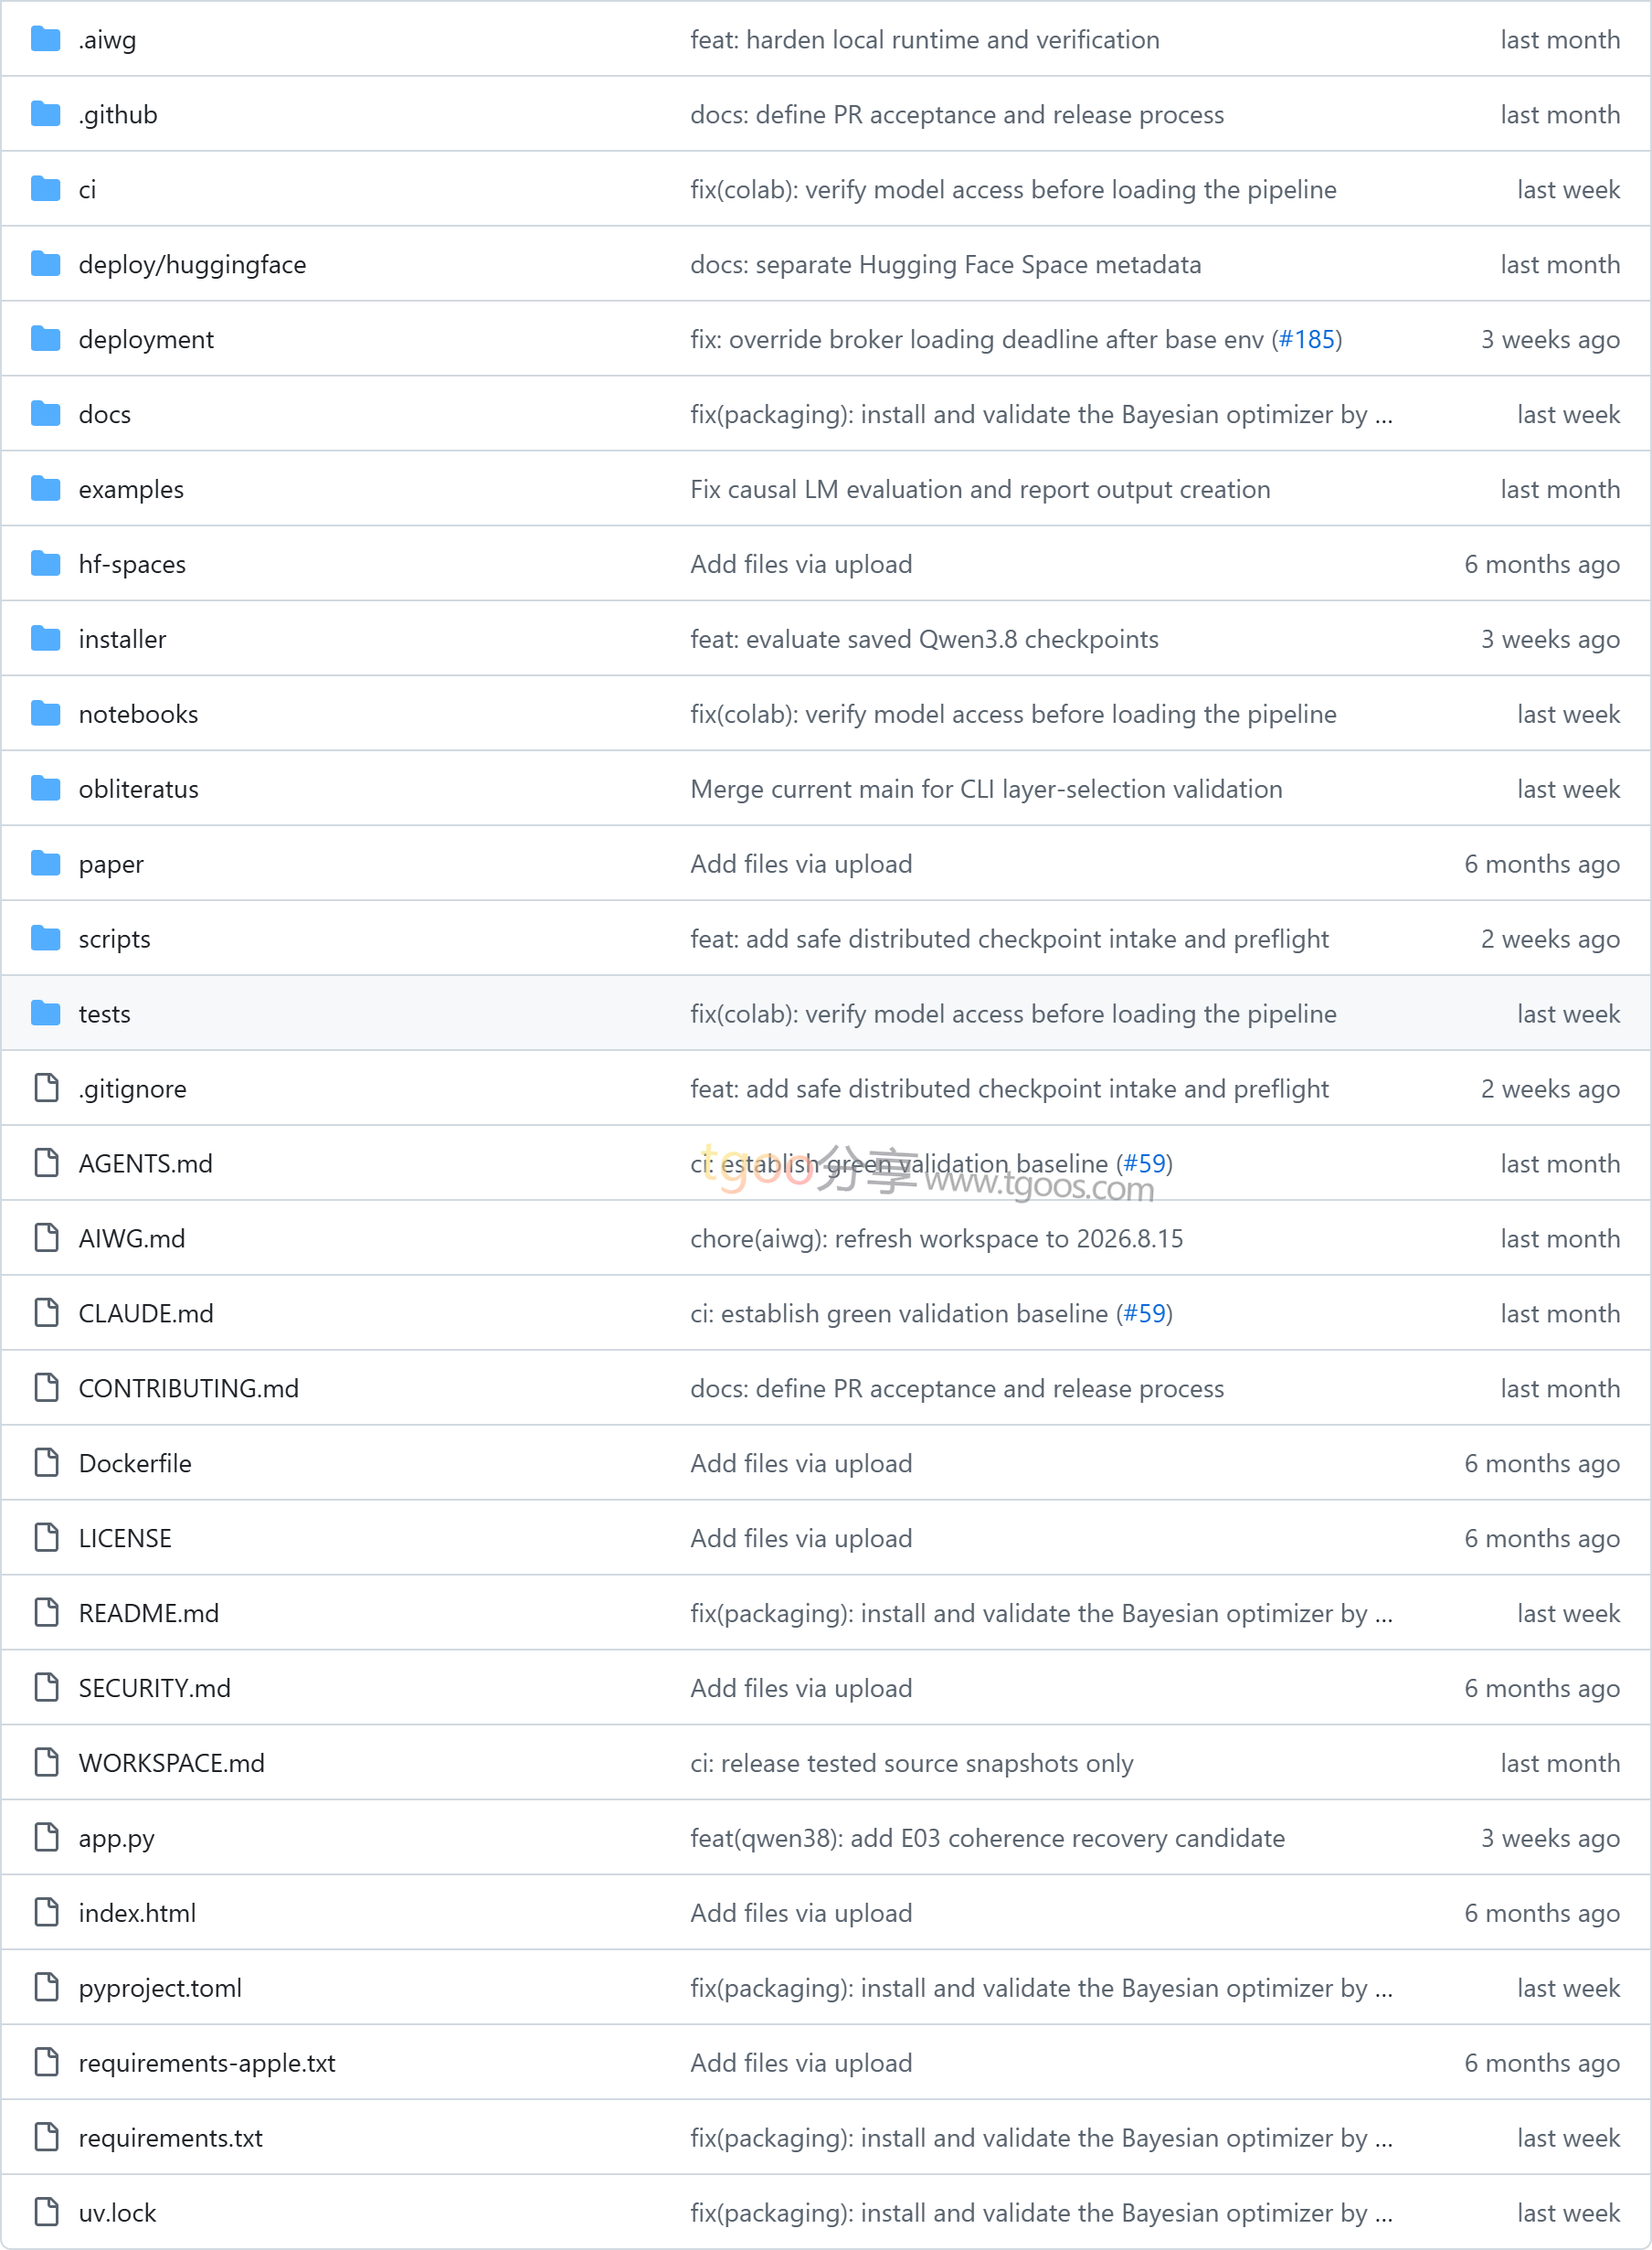
OBLITERATUS项目目录截图
OBLITERATUS项目核心亮点
- 🧠 完整消融管线,无需重新训练:OBLITERATUS 将流程拆解为 SUMMON、PROBE、DISTILL、EXCISE、VERIFY、REBIRTH 六个阶段。它会先加载模型,收集限制性与非限制性提示下的激活,再通过 SVD 提取拒绝方向,最后以保范数投影的方式移除这些方向,并检查模型困惑度与连贯性是否仍然正常。
- 🔬 15 个深度分析模块:项目不只是“删除护栏”,还试图回答拒绝行为到底如何形成。分析模块覆盖跨层对齐、Refusal Logit Lens、Whitened SVD、概念锥几何、对齐印记检测、Ouroboros 自修复效应、跨模型通用性指数等方向,让研究者能够先理解“锁链”的结构,再决定如何切断。
- 🎛️ 七种权重投影预设 + 可逆干预:从 basic、advanced、aggressive、surgical、optimized、inverted 到 nuclear,OBLITERATUS 提供不同强度与精度的消融方法。同时,它也支持 steering vectors 推理时干预,通过 Hook 在生成阶段临时调整模型行为,不必永久修改权重,具有可撤销、可调 alpha、可组合的特点。
- 📊 社区众包研究实验:OBLITERATUS 把每一次消融运行都视为一个科研数据点。开启匿名遥测后,运行结果会贡献到社区数据集,用于分析不同架构、训练方法和硬件下的拒绝方向规律。HuggingFace Spaces 上默认开启遥测,并提供社区 Leaderboard,让零代码用户也能参与研究。
- 🚀 多种使用入口,从零代码到 API 全覆盖:你可以在 HuggingFace Spaces 上点击即用,也可以启动本地 Gradio Web UI;可以在 Google Colab 免费 GPU 上运行,也可以用 CLI、Python API 或 YAML 配置文件进行可复现实验。项目还提供 116 个精选模型预设,按显存需求分为 Tiny、Small、Medium、Large、Frontier 五个层级。
- 🧩 工程化与可复现性:支持权重量化、多 GPU 放置、远程 SSH 执行、FP8/NVFP4 布局识别、离线结构检查等能力。测试套件覆盖分析模块、架构检测、社区贡献、评估指标和边界情况,标签发布版本包含超过 1500 个 CPU 测试,强调研究过程的可验证与可复现。
OBLITERATUS项目快速开始
只需几步,你就能在本地运行起 OBLITERATUS:
- 安装核心包:
bash

pip install -e . - 如果需要本地 Web UI 或量化支持:
“`bash
# Web UI
pip install -e “.[spaces]”8bit / 4bit 量化
pip install -e “.[quantization]”
“` - 启动本地 Gradio 界面:
bash

obliteratus ui - 或者直接用 CLI 执行一次消融:
bash

obliteratus obliterate meta-llama/Llama-3.1-8B-Instruct --method advanced - 查看模型目录、策略和预设:
bash

obliteratus models

obliteratus strategies

obliteratus presets - 通过 Python API 接入自己的研究流程:
“`python
from obliteratus.abliterate import AbliterationPipelinepipeline = AbliterationPipeline(
model_name=”meta-llama/Llama-3.1-8B-Instruct”,
method=”advanced”,
output_dir=”abliterated”,
)
result = pipeline.run()directions = pipeline.refusal_directions
metrics = pipeline._quality_metrics
“`
如果你不想写任何代码,也可以直接使用 README 中提供的 HuggingFace Spaces 入口,或在 Google Colab 中选择模型并点击 Run All。对于更严肃的复现实验,可以使用 YAML 配置文件运行完整消融研究:
obliteratus run examples/gpt2_layer_ablation.yaml
OBLITERATUS项目应用场景
- 对齐机制研究:研究者可以观察拒绝方向在不同层中的演化,分析 DPO、RLHF、CAI、SFT 等对齐方式留下的几何印记,并评估现有安全训练对权重级干预的鲁棒性。
- 红队与安全评估:红队测试者可以使用 OBLITERATUS 建立无限制基线模型,对比原始模型与消融模型在拒绝率、困惑度、KL 散度、连贯性等指标上的差异,从而更系统地理解安全护栏的边界。
- 本地模型行为控制:对于在自己的硬件上运行模型的开发者,OBLITERATUS 提供了从 Web UI 到 CLI 再到 Python API 的完整路径,让部署者可以决定模型行为,而不是完全依赖训练时锁定的策略。
- 模型对比与可解释性教学:通过 A/B Compare、Strength Sweep 和 Benchmark 标签页,用户可以并排观察原始模型与消融模型的输出差异,也可以调整消融强度,直观看到“合规性”和“连贯性”之间的权衡。
- 社区数据聚合与论文复现:项目提供
obliteratus aggregate命令,可以将社区贡献结果汇总为 summary 或 LaTeX 表格,适合用于论文、报告和可复现研究。
用户案例:目前,OBLITERATUS 主要通过 HuggingFace Spaces、Google Colab、CLI 和 Python API 被对齐研究者、红队测试者、安全评估人员以及本地模型实践者使用。其 HuggingFace Spaces 和社区 Leaderboard 正在汇聚跨模型、跨方法、跨硬件的消融结果,形成一份持续增长的众包研究数据集。
需要特别强调的是,OBLITERATUS 是一个研究、红队、安全评估和机制可解释性工具。它移除安全护栏后的模型会生成原始模型可能拒绝的内容,因此使用者必须自行承担合规与责任,不应将其用于对真实人物造成伤害的场景。
OBLITERATUS项目链接
- GitHub 仓库:https://github.com/elder-plinius/OBLITERATUS
- 在线体验:README 中提供的 HuggingFace Spaces 入口
- 许可模式:AGPL-3.0 开源许可 + 商业许可双授权elder-plinius / OBLITERATUS项目地址:https://github.com/elder-plinius/OBLITERATUS本文地址:https://www.tgoos.com/46800
