MOSS-TTS:一个覆盖长语音、多说话人对话到实时流式的开源语音与声音生成模型家族
你是否曾经遇到过这样的困境:手里只有一段参考音频,却希望模型既能克隆音色、又能准确念出每一个多音字,还要在几十分钟的长文本上保持稳定不崩坏;而当你想做一个能实时对话的语音 Agent 时,又发现普通的 TTS 模型响应太慢、上下文不连贯?更别提还要生成环境音效、设计全新音色、做多说话人播客配音——单靠一个 TTS 模型,往往怎么也凑不齐。
MOSS-TTS Family 的出现,正是为了彻底解决这个”一个模型扛不下所有活”的问题。它是由 MOSI.AI 与 OpenMOSS 团队开源的一整套语音与声音生成模型家族,用 Python 实现,把真实生产场景拆解成五个可独立使用、也可自由编排成完整流水线的模型:MOSS-TTS(旗舰高保真与零样本克隆)、MOSS-TTSD(多说话人口语对话)、MOSS-VoiceGenerator(音色设计)、MOSS-TTS-Realtime(实时流式语音)、MOSS-SoundEffect(环境音效生成),并配套了统一的 MOSS-Audio-Tokenizer 离散音频接口与轻量级的 MOSS-TTS-Nano。本文将带你全面了解这个潜力新星。
截至收录:
MOSS-TTS stars数:4111
MOSS-TTS forks数:373
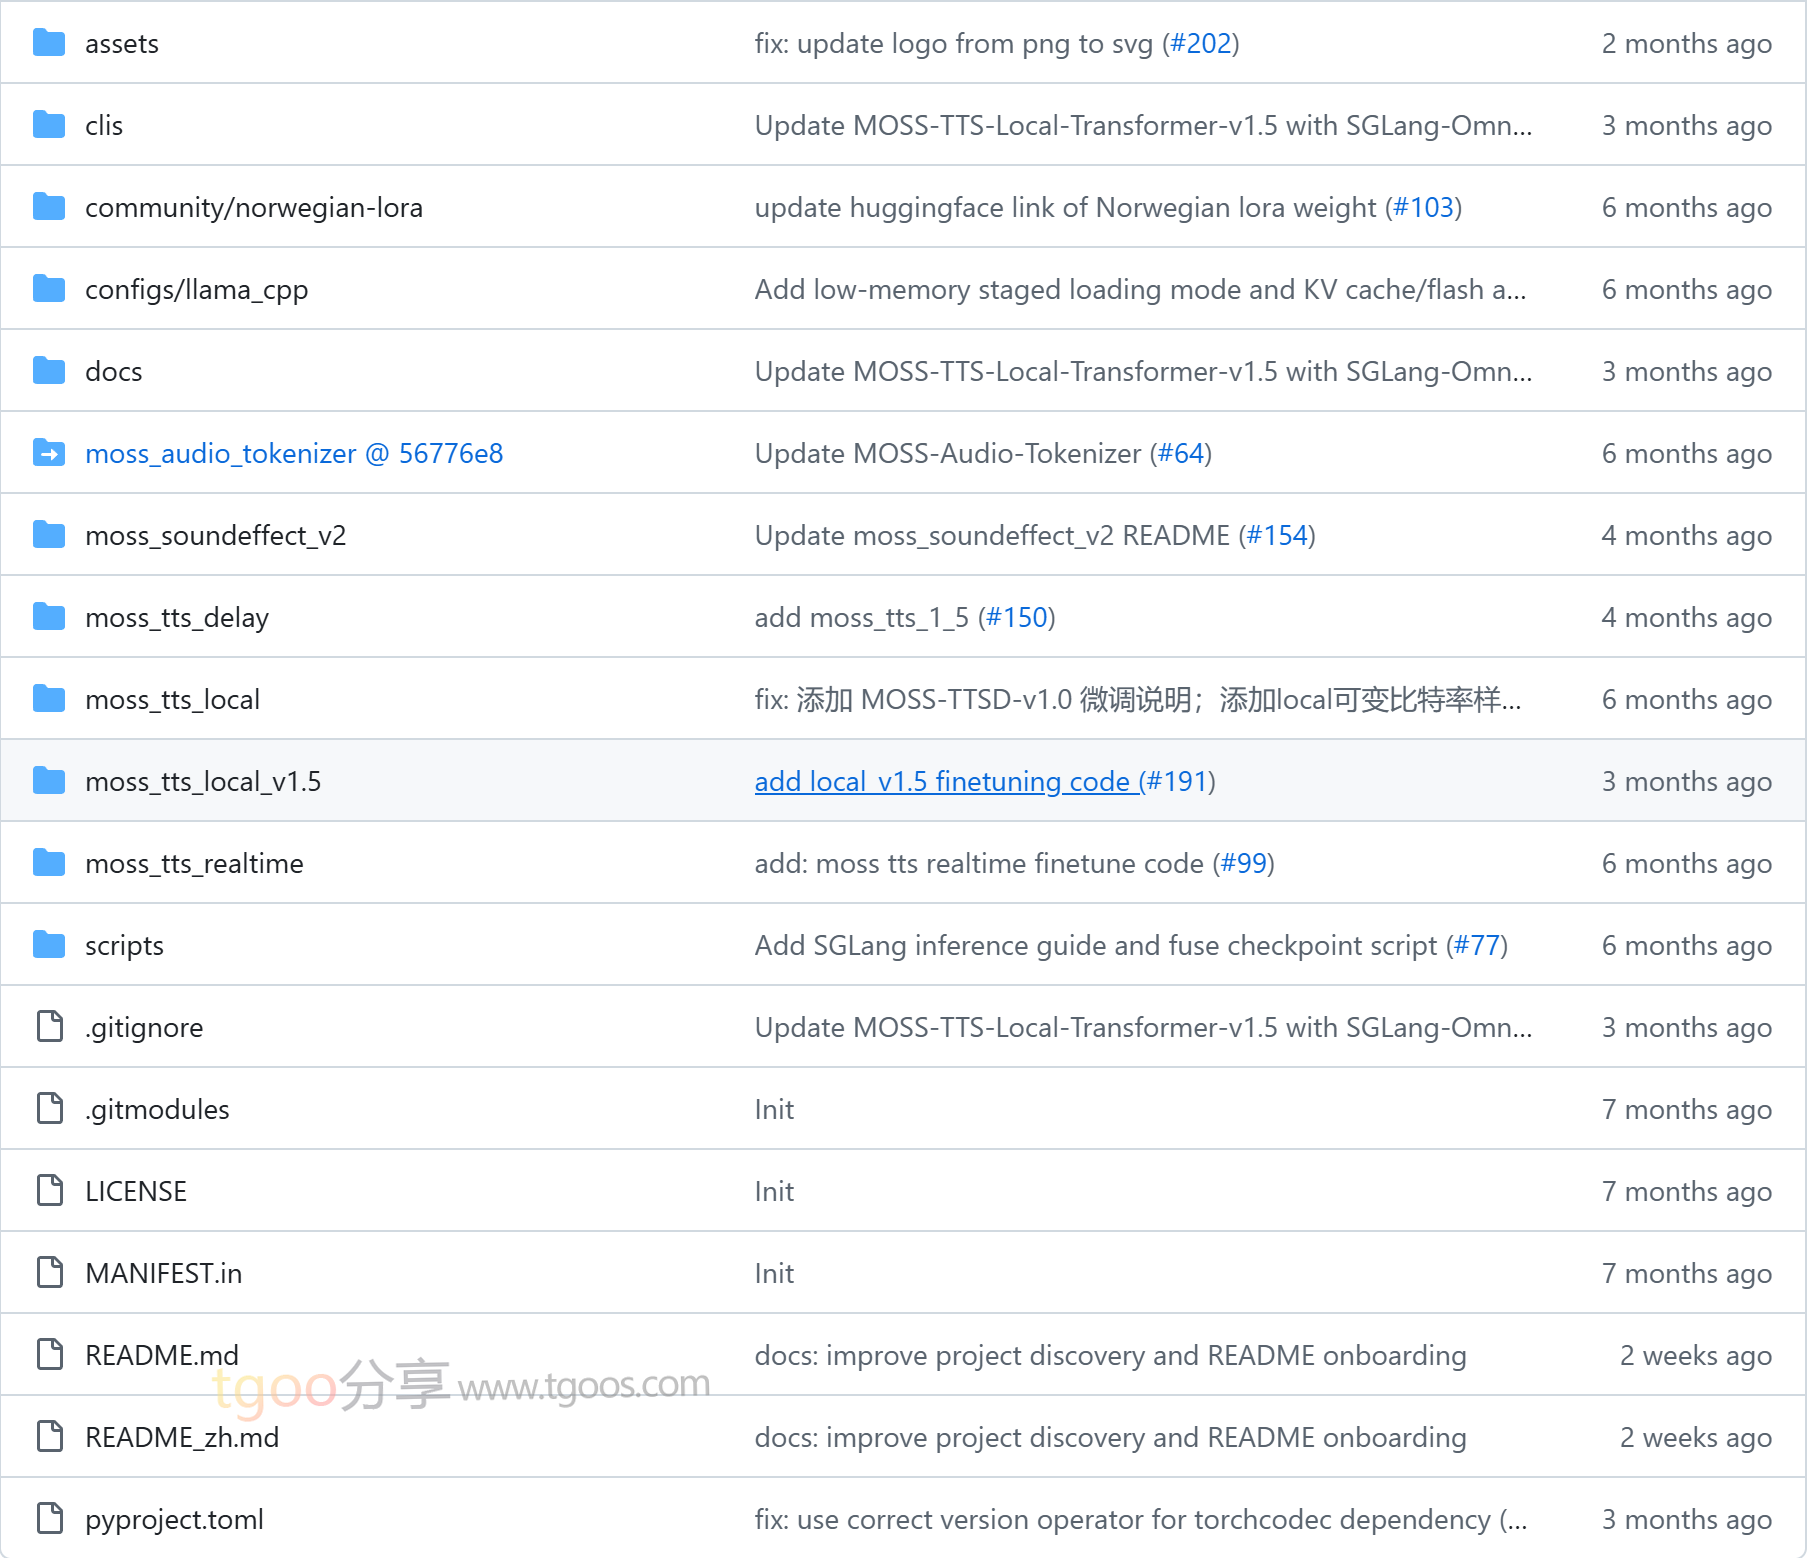
MOSS-TTS项目目录截图
MOSS-TTS项目核心亮点
- 🧩 一个家族,五种模型,按需组合:MOSS-TTS Family 不追求”一个模型包打天下”,而是提供 MOSS-TTS(高保真长语音与零样本克隆)、MOSS-TTSD(多说话人超长对话)、MOSS-VoiceGenerator(文本直接设计音色)、MOSS-TTS-Realtime(多轮上下文实时合成)、MOSS-SoundEffect(可控时长音效生成)五个生产级模型,既可单独部署,也能编排成完整流水线。
- 🎙️ 极致保真,原生 48 kHz 立体声:MOSS-TTS-Local-Transformer-v1.5 采用 MOSS-Audio-Tokenizer-v2 作为音频分词器,原生支持 48 kHz 立体声输入输出,带来更丰富的空间细节与更自然的听感;MOSS-Audio-Tokenizer 则以 32 层 RVQ 把 24 kHz 音频压缩到仅 12.5 Hz 的极低帧率,在 0.125–4 kbps 可变码率下仍保持业界领先的重建质量。
- 🌍 31 种语言与代码切换:MOSS-TTS-v1.5 与 Local-Transformer-v1.5 在 1.0 版本 20 种语言的基础上,扩展出粤语、荷兰语、芬兰语、印地语、马其顿语、马来语、罗马尼亚语、斯瓦希里语、他加禄语、泰语、越南语等共 31 种语言,并支持语言标签指定,多语种混说场景表现更稳。
- ⚡ 实时流式,TTFB 仅 180 ms:MOSS-TTS-Realtime 采用增量合成与层次化文本–音频输入建模多轮上下文,首字节延迟低至 180 ms,搭配 LLM 首句生成的 197 ms,整体端到端约 377 ms,RTF 仅 0.51(单卡 L20),是构建低延迟语音 Agent 的理想底座。
- 🎛️ 细粒度可控:拼音、音标、时长与停顿:支持 Pinyin 与 IPA 输入精准控制发音,
tokens参数控制生成长度,还可以用[pause 3.2s]这样的内联标记显式指定停顿,例如”我今天学习了一首中国的古诗,它的名字是[pause 3.2s]静夜思!”——标点驱动的韵律在长句中也更稳定。 - 🖥️ 从 GPU 集群到 4 核 CPU 的全谱系部署:既可接入 SGLang-Omni、vLLM-Omni 等高性能推理后端(提供 OpenAI 兼容的
/v1/audio/speech接口与流式、克隆能力),也支持 llama.cpp 免 PyTorch 推理路径(ONNX / TensorRT 音频分词器),甚至提供 8 GB 显存的低内存模式;MOSS-TTS-Nano 更是只有 0.1B 参数,在仅 4 个 CPU 核心上即可实时生成。 - 📜 Apache 2.0 开源,配套生态完整:整个家族模型以 Apache License 2.0 授权,附有技术报告、逐架构微调教程、客观与主观评测数据,以及 ComfyUI 节点、OpenAI 兼容 API、播客生成工具等社区项目,开箱即可落地。
MOSS-TTS项目快速开始
只需几步,你就能在本地跑起 MOSS-TTS:
- 创建隔离环境(推荐 Python 3.12 + Transformers 5.0.0):
bash

conda create -n moss-tts python=3.12 -y

conda activate moss-tts - 安装 FFmpeg 系统依赖(torchcodec 音频 I/O 所需):
“`bash
Debian/Ubuntu
sudo apt-get install -y ffmpeg
macOS
brew install ffmpeg
“` - 克隆仓库并安装 Python 依赖:
bash

git clone https://github.com/OpenMOSS/MOSS-TTS.git

cd MOSS-TTS

pip install --extra-index-url https://download.pytorch.org/whl/cu128 -e ".[torch-runtime]"
也可以使用
uv(速度更快):bash
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install --torch-backend cu128 -e ".[torch-runtime]" - 可选:安装 FlashAttention 2(需要受支持的 GPU,可提速并降低显存占用):
“`bash
pip install –extra-index-url https://download.pytorch.org/whl/cu128 -e “.[torch-runtime,flash-attn]”内存有限时限制编译并行度
MAX_JOBS=4 pip install –extra-index-url https://download.pytorch.org/whl/cu128 -e “.[torch-runtime,flash-attn]”
“` - 运行你的第一次语音生成:
“`python
import torch
from transformers import AutoModel, AutoProcessorpretrained_model_name_or_path = “OpenMOSS-Team/MOSS-TTS-v1.5”
device = “cuda” if torch.cuda.is_available() else “cpu”
dtype = torch.bfloat16 if device == “cuda” else torch.float32processor = AutoProcessor.from_pretrained(pretrained_model_name_or_path, trust_remote_code=True)
processor.audio_tokenizer = processor.audio_tokenizer.to(device)model = AutoModel.from_pretrained(
pretrained_model_name_or_path,
trust_remote_code=True,
attn_implementation=”flash_attention_2″, # 或 “sdpa” / “eager”
dtype=dtype,
).to(device)
model.eval()text = “Bonjour, je voudrais essayer une voix française naturelle et stable.”
conversations = [
# 直接合成(v1.5 推荐显式指定语言标签)
[processor.build_user_message(text=text, language=”French”)],
# 语音克隆(传入参考音频)
[processor.build_user_message(text=text, reference=[“reference_zh.wav”])],
# 显式停顿控制
[processor.build_user_message(text=”我今天学习了一首中国的古诗,它的名字是[pause 3.2s]静夜思!”)],
]with torch.no_grad():
batch = processor(conversations, mode=”generation”)
outputs = model.generate(
input_ids=batch[“input_ids”].to(device),
attention_mask=batch[“attention_mask”].to(device),
max_new_tokens=4096,
)
for i, message in enumerate(processor.decode(outputs)):
audio = message.audio_codes_list[0]
print(f”sample{i}.wav 已生成,采样率 {processor.model_config.sampling_rate}”)
“` - 想要可视化体验? 每个模型都提供了现成的 Gradio 脚本:
“`bash
MOSS-TTS / MOSS-TTSD / MOSS-VoiceGenerator / MOSS-SoundEffect
python clis/moss_tts_app.py
python clis/moss_ttsd_app.py
python clis/moss_voice_generator_app.py
python clis/moss_sound_effect_app.pyLocal-Transformer-v1.5(含 48 kHz 立体声与实时流式解码示例)
python clis/moss_tts_local_v1.5_app.py
“`
MOSS-TTS项目应用场景
场景一:播客制作与有声书/长文本朗读:创作者可以用 MOSS-TTSD 生成多说话人、超长时长的对话式内容,用 MOSS-TTS-v1.5 完成几十集有声书的批量录制。v1.5 针对长句标点韵律和”长参考音频 + 短目标文本”场景做了专门优化,克隆相似度更稳定、跨次生成方差更小,不再需要反复重录。
场景二:实时语音助手与语音 Agent:开发者可以构建多轮上下文感知的实时语音对话系统,MOSS-TTS-Realtime 会对历史文本与用户声学特征同时建模,保证多轮回复连贯且音色一致。搭配 LLM 使用时,端到端首句延迟约 377 ms,非常适合客服机器人、AI 陪伴、车载语音等对延迟敏感的产品。
场景三:影视、游戏与互动内容的音效与配音:借助 MOSS-SoundEffect,团队可以按类别和时长可控地生成自然环境、城市场景、生物声音、人声动作与音乐片段;借助 MOSS-VoiceGenerator,无需参考音频即可用自然语言描述直接”设计”出角色音色,并在竞技场评分中超越了其他顶尖音色设计模型。
场景四:多语言内容本地化与端侧部署:面向出海产品的团队可以用 31 种语言支持批量生成多语种配音;面向硬件厂商,MOSS-TTS-Nano 仅 0.1B 参数、4 核 CPU 即可实时流式合成,配合 llama.cpp 免 PyTorch 路径(含 8 GB 显存的低内存模式与纯 CPU 配置),可在边缘设备、浏览器与轻量 Web 服务上落地。
用户案例:目前围绕 MOSS-TTS 已成长出活跃的社区生态——MOSS-TTS ComfyUI(可零样本克隆、续写与时长控制的节点包)、ComfyUI-MOSS-TTS、MOSS-TTS-OpenAI(OpenAI 兼容 TTS API)、AnyPod(以 MOSS-TTS/MOSS-TTSD 为后端的播客生成工具),以及由 Tosee 的 Martin Bergo 基于 NbAiLab/NST 挪威语语音数据集训练的 Norwegian LoRA(ToSee-Norway/MOSS-TTS-Norwegian-LoRA)等,都被用于改善各自的工作流。
MOSS-TTS项目链接
OpenMOSS / MOSS-TTS项目地址:https://github.com/OpenMOSS/MOSS-TTS
本文地址:https://www.tgoos.com/46403
