train-llm-from-scratch:从零手写 PyTorch Transformer,单卡也能训练并微调你自己的 LLM
你是否曾经被「想搞懂大模型,却只看到一堆封装好的库」所困扰?trl、peft、transformers 这些高层 API 固然好用,但调来调去,始终不知道自己调的到底是什么。train-llm-from-scratch 的出现,旨在彻底解决这个问题。它是一个用纯 PyTorch 从零实现 Transformer 的完整训练教程项目,帮助你从原始文本出发,一路走到一个能对齐、能推理的助手模型——并且每个算法都是手写的,不依赖任何现成的高层框架。本文将带你全面了解这个潜力新星。
作者 FareedKhan-dev 目前正在寻找 AI 方向的博士职位,他把整个从预训练到后训练的旅程浓缩成了一句核心理念:把文本变成数字,预测下一个 token,然后不断调整数据和损失,直到模型做出我们想要的输出。整条路径清晰得就像一条流水线:
raw text -> tokens -> a Transformer -> next-token loss -> a base model
base model -> SFT -> Reward Model -> {PPO, DPO} -> GRPO -> evaluation and chat
截至收录:
train-llm-from-scratch stars数:9633
train-llm-from-scratch forks数:1327
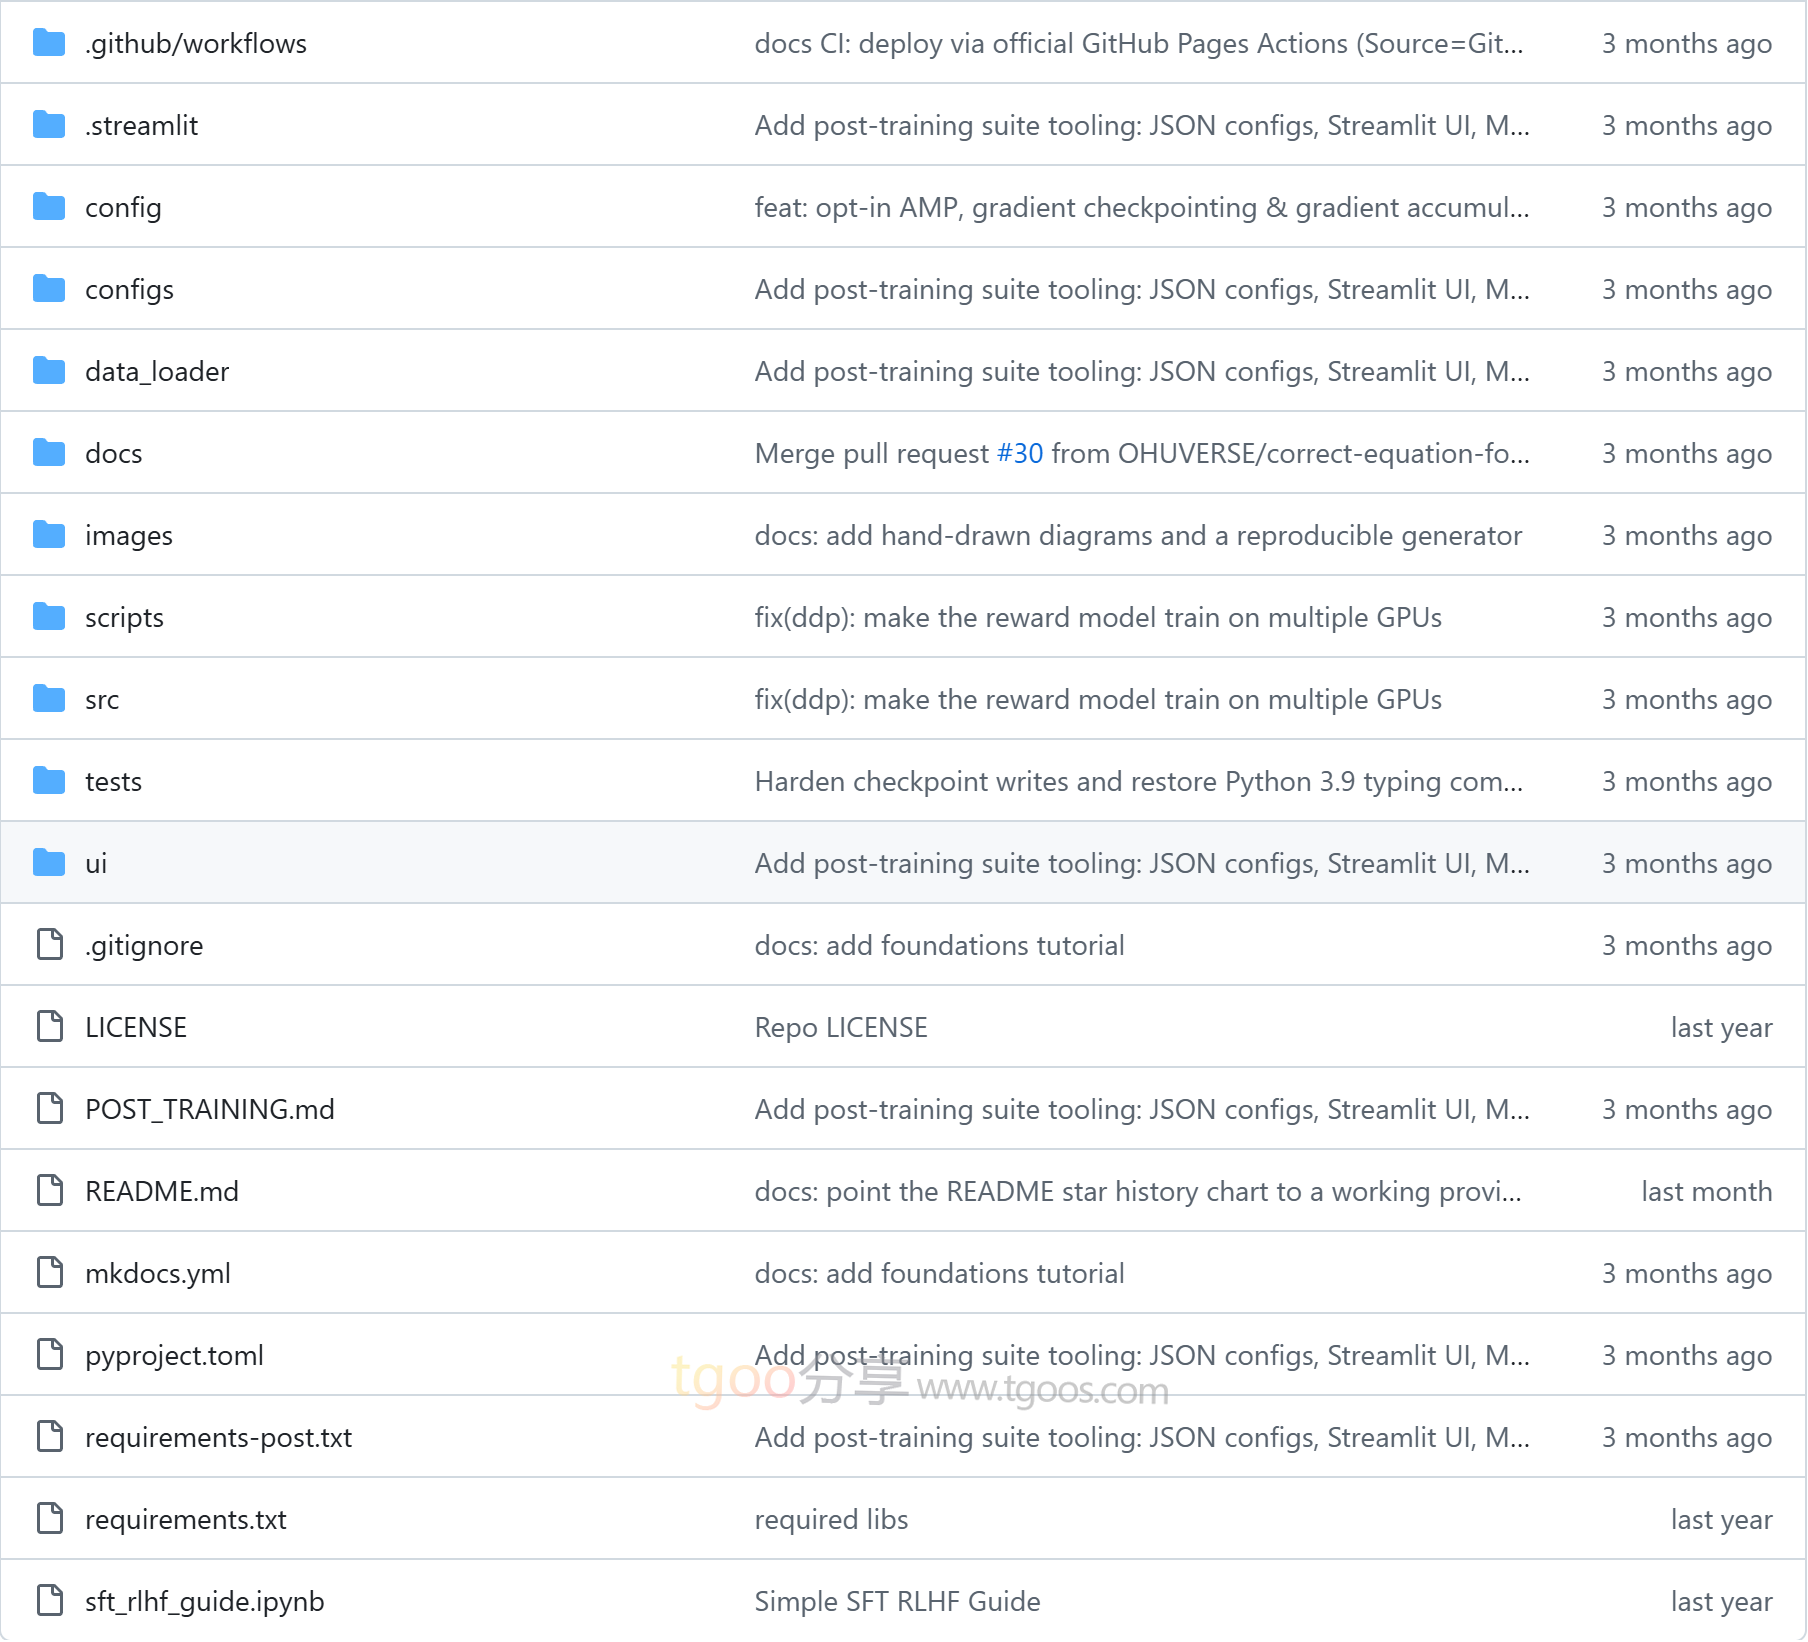
train-llm-from-scratch项目目录截图
train-llm-from-scratch核心亮点
🧱 亮点一(纯 PyTorch,拒绝黑盒):整个项目不使用 trl、peft、transformers 等封装库。从 MLP、单头注意力、多头注意力、Transformer Block 到完整模型,每一块都是手写的 nn.Module,代码短到可以一口气读完,真正做到「知其然,也知其所以然」。
🎓 亮点二(全流程教学,从数据到对话):覆盖了 LLM 训练的完整生命周期——数据下载与分词、预训练、SFT 指令微调、Bradley-Terry 奖励模型、PPO / DPO / ORPO / KTO、以及 2025 年 DeepSeek-R1 风格的 GRPO / RLVR,最后还有统一的评估和聊天脚本。一个仓库,一条龙走完。
💻 亮点三(单卡友好,免费 Colab 就能跑):13M 参数的小模型在免费的 Colab 或 Kaggle T4 上就能训练。项目还提供 --amp、--grad-checkpointing、--grad-accum 等显存优化开关,配合不同显卡的显存对照表,让你清楚知道自己的设备能训多大的模型。
🎛️ 亮点四(可视化控制台与文档站):内置基于 Streamlit 的控制面板,每个训练阶段一个页面(Data、Pretrain、SFT、Reward、DPO、PPO、GRPO、Evaluate、Chat),点点鼠标就能启动任务、实时观察 loss 曲线;同时配有 MkDocs 文档站,深入讲解每一阶段的原理、图示和指标含义。
train-llm-from-scratch快速开始
只需几步,你就能在本地跑起属于自己的 LLM 训练流水线:
- 安装(克隆仓库并以可编辑模式安装,自动配置好
config、src、data_loader、ui的导入路径):
“`bash
git clone https://github.com/FareedKhan-dev/train-llm-from-scratch.git
cd train-llm-from-scratch
pip install -e .可选依赖,按需安装
pip install -e “.[train]” # datasets + wandb,用于数据下载与日志
pip install -e “.[ui]” # streamlit + pandas + altair,用于控制面板
pip install -e “.[docs]” # mkdocs,用于文档站
pip install -e “.[all]” # 全家桶
“` - 准备数据并训练你的第一个 13M 模型:
“`bash
# 下载并分词 The Pile 的一个切片
python scripts/data_download.py
python scripts/data_preprocess.py在 config/config.py 设置 13M 配置后,启动预训练
python scripts/train_transformer.py
“` - 生成文本,看看模型学到了什么:
bash

python scripts/generate_text.py \

--model_path models/transformer_B.pt \

--input_text "The" \

--max_new_tokens 100
如果你想体验完整链路(预训练 + SFT + 奖励模型 + DPO + PPO + GRPO + 评估),一个脚本就能搞定:
bash scripts/run_posttraining.sh            # 用满双卡
NPROC=1 bash scripts/run_posttraining.sh    # 单卡模式
还有一个几秒就能跑完的 smoke 测试,用来快速验证代码环境是否正常:
python tests/test_post_training_smoke.py # 纯 CPU 上验证核心数学逻辑
train-llm-from-scratch应用场景
场景一:AI 学习者的最佳实践项目——如果你是学生或刚转行 AI 的开发者,可以按照 README 从上到下阅读,每一段代码前都有平白的解释,每一段代码后都有预期输出。作者专门设计了三种阅读路径:学生从头读、开发者直接复制命令跑、研究者深挖后训练部分的 SFT / Bradley-Terry / PPO-GAE / DPO / GRPO 细节。这可能是目前 GitHub 上最适合「照着做一遍」的 LLM 全流程教程。
场景二:科研人员的算法实验台——整条后训练链路都建立在同一个仅 77M 参数的小型 Transformer 之上,无需庞大的算力,就能完整复现奖励模型训练、PPO 的 GAE 优势估计、DPO 的隐式奖励对齐、GRPO 的组相对优势等前沿算法。作者甚至贴出了真实运行结果:77M 基座模型在 2×L40 GPU 上训练到 dev loss 3.76,奖励模型在 7974 对真实偏好数据上达到 0.574 的偏好准确率。
场景三:小团队快速验证想法——如果你想在一个可控的小模型上验证某个微调策略或对齐算法,而不想被 transformers 的抽象层绊住手脚,这个项目提供了极佳的可读性和可修改性。wrap, do not rewrite 的设计哲学意味着所有后训练算法都围绕 forward_hidden 这一个小接口展开,改造起来非常轻松。
用户案例:虽然这是一个偏教学性质的开源项目,但它已经被大量 LLM 学习者和研究者用作「从零理解大模型训练」的参考实现。项目的文档站(https://fareedkhan-dev.github.io/train-llm-from-scratch/ )还专门设有一个 Foundations 板块,把 tokenization、decoder-only Transformer、注意力机制、优化目标、生成方式等前置知识讲透,非常适合作为系统学习的起点。作者的训练输出也真实展示了 13M 小模型从「胡言乱语」到「勉强成句」的进化过程——这正是每个大模型研究者都经历过的激动时刻。
train-llm-from-scratch链接
FareedKhan-dev / train-llm-from-scratch项目地址:https://github.com/FareedKhan-dev/train-llm-from-scratch
本文地址:https://www.tgoos.com/46428
