LiteParse项目:用 Rust 打造的极速本地 PDF 解析器,每页仅需 2~5 毫秒
你是否曾经被这样的场景困扰:手头有一堆 PDF 文档要喂给大模型或 RAG 管道,但市面上的解析工具要么必须联网调用云端 API、要么动辄需要 GPU 和庞大的布局模型?LiteParse 的出现,旨在彻底解决这个问题。它是一个用 Rust 编写的独立开源 PDF 解析工具,专注于「快」和「轻」两件事——基于 PDFium 提供带边界框的高质量空间文本解析,不依赖任何专有 LLM 特性,也不需要云端服务,一切都在你的本地机器上跑完。
截至收录:
LiteParse项目stars数:12320
LiteParse项目forks数:849
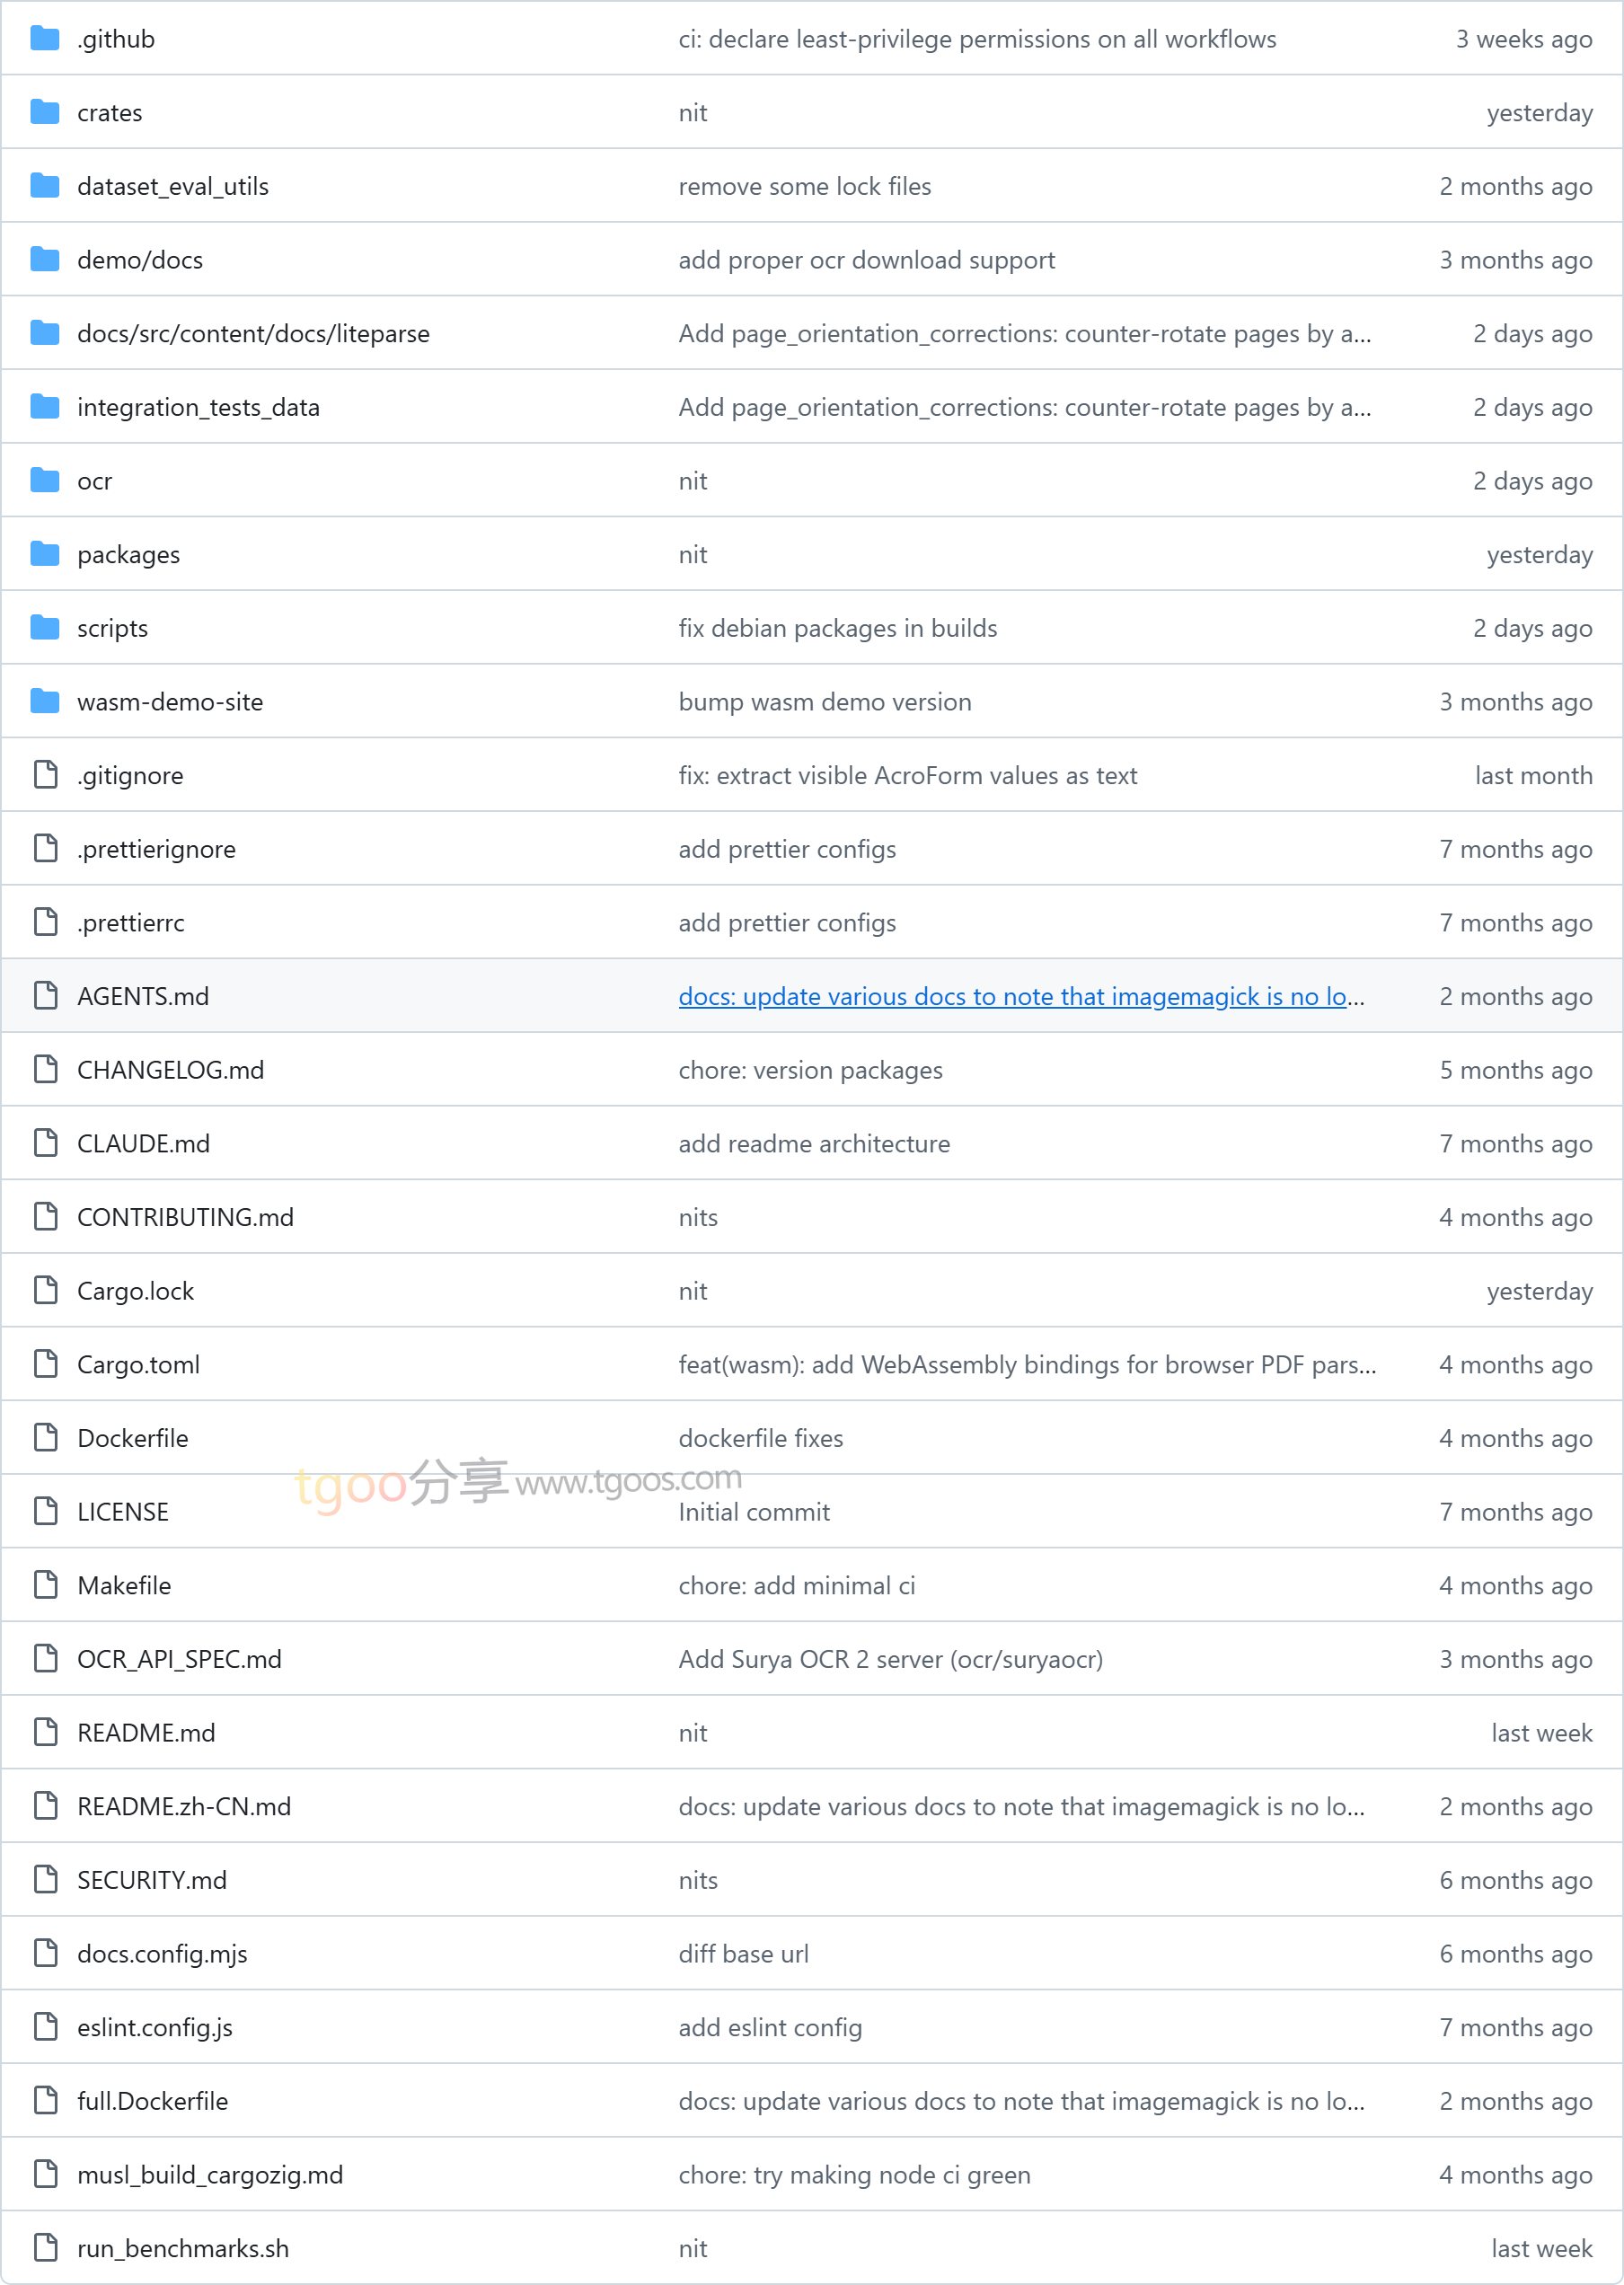
LiteParse项目目录截图
LiteParse项目核心亮点
- ⚡ 极致解析速度:基于 PDFium 做空间文本解析,平均每页仅需约 2~5 毫秒,且全程不加载任何 ML 模型(无 LLM、无版面分析模型、无 GPU)。
- 🧠 灵活的 OCR 体系:内置 Tesseract,开箱即用、零配置、随库打包;同时支持接入任意符合规范的 HTTP OCR 服务器(EasyOCR、PaddleOCR 或自研服务),只需实现一个简单的 OCR API 规范即可。
- 🔍 廉价复杂度检测:
lit is-complex命令用一次纯文本层的轻量扫描,就能判断文档是否需要 OCR 或更重的解析——你可以在完整解析之前先做路由、拒绝或成本估算。 - 📝 结构化 Markdown 输出:能从空间布局中重建标题、表格、列表、图片和链接,输出为 Markdown / JSON / Text 三种格式,非常适合直接投喂 LLM 与 RAG 管道。
- 🎯 精确边界框定位:每个文本项都带有精准的坐标信息;开启
--extract-blocks后,连表格里每个单元格都有自己的 bbox,可以精确回溯到页面上的原始区域。 - 🧵 Worker Pool 真并行:Python 与 Node.js 版本支持在常驻工作进程中解析,绕过 PDFium 对并发解析的串行化限制,并提供单次解析硬超时——异常文档会被直接杀掉并按文件名标记,永远不会拖垮整条流水线。
- 🖼 高质量页面截图:为 LLM 智能体生成页面截图,让模型能看到纯文本无法承载的图表、印章与排版信息,并可选检测空白页与纯色矩形区域。
- 🌐 全语言生态覆盖:同一套 CLI 与核心能力,可从 Rust、Node.js / TypeScript、Python 调用,甚至直接在浏览器里通过 WASM 运行;支持 Linux、macOS(Intel / ARM)、Windows。
在公开的 Doc→Markdown 基准测试中,LiteParse 对比同类「无模型」工具表现突出:在 opendataloader-bench(200 篇文档)上取得 0.886 的综合分(接入 PaddleOCR 后提升至 0.901),olmOCR-bench 测试通过率 39.6%(接入 OCR 后达 42.2%),均领先于其他免模型方案。
LiteParse项目快速开始
只需几步,你就能在本地运行起 liteparse。所有非 WASM 版本都自带同一个 lit 命令行工具:
- 安装(按你的语言生态任选其一):
“`bash
# Node.js / TypeScript
$ npm i -g @llamaindex/liteparsePython
$ pip install liteparse
Rust(CLI 与库)
$ cargo install liteparse
浏览器 / WASM
$ npm i @llamaindex/liteparse-wasm
“` - 解析你的第一个 PDF:
“`bash
# 基础解析
$ lit parse document.pdf输出结构化 Markdown(含标题、表格、列表、图片、链接)
$ lit parse document.pdf –format markdown -o output.md
只解析指定页面
$ lit parse document.pdf –target-pages “1-5,10,15-20”
“` - 解析前先判断文档复杂度:
“`bash
# 打印复杂度判定结果与逐页 JSON
$ lit is-complex document.pdf作为 shell 断言使用:只在文档简单时跳过 OCR 解析
$ lit is-complex document.pdf –quiet && lit parse document.pdf –no-ocr
“` - 批量处理与截图:
“`bash
# 批量解析整个目录
$ lit batch-parse ./input-directory ./output-directory为 LLM 智能体生成页面截图
$ lit screenshot document.pdf -o ./screenshots –dpi 300
“`
此外,LiteParse 还支持多格式输入:Word / PowerPoint / Excel 等 Office 文档可通过 LibreOffice 自动转换为 PDF 后解析,JPG、PNG、WebP、SVG 等图片格式则原生支持(自 v2.8.0 起无需 ImageMagick)。
LiteParse项目应用场景
- RAG 与知识库构建:用
--format markdown把海量 PDF 转成带标题层级的结构化 Markdown,直接灌入向量库或喂给大模型,避免原始 PDF 噪声污染检索质量。 - 生产级文档流水线路由:在正式解析前用
lit is-complex做一次廉价探测,简单文档走本地快速通道,复杂文档(密集表格、多栏排版、扫描件)再路由到更强的解析服务,兼顾成本与准确率。 - LLM 智能体视觉输入:用
lit screenshot生成高 DPI 页面截图,让 Agent 能够读取图表、手写批注和扫描件中的视觉信息,补齐纯文本解析的盲区。 - 批量文档批处理:借助
lit batch-parse与 Worker Pool 并行模式,一次性处理整个目录的文档,并为每次解析设置硬超时,保证流水线不会被个别异常文件阻塞。 - PDF 结构数据挖掘:通过
--extract-vector-graphics、--extract-form-fields、--extract-annotations、--extract-structure-tree等选项,把矢量图形、表单字段、标注和标签化 PDF 的逻辑结构导出为 JSON,用于文档审计、数据抽取和格式转换。
用户案例:LiteParse 由 LlamaIndex 团队(run-llama)开源维护,与云端解析服务 LlamaParse 同源。推荐的使用模式是——本地能搞定的就交给 LiteParse 快速处理,遇到密集表格、多栏布局、图表、手写文本或扫描件这类「硬骨头」时,再切换到 LlamaParse 获取更干净的 Markdown 与结构化数据,形成本地与云端互补的文档解析方案。此外,它还可以作为 Agent Skill 直接接入智能体工作流:npx skills add run-llama/llamaparse-agent-skills --skill liteparse。
LiteParse项目链接
run-llama / liteparse项目地址:https://github.com/run-llama/liteparse
本文地址:https://www.tgoos.com/46413
