Biohub ESM:蛋白质生物学的世界模型,让预测、设计与发现蛋白质更高效
你是否曾经被蛋白质结构预测、功能注释和从头设计之间相互割裂、门槛高、算力昂贵所困扰?Biohub ESM 的出现,旨在用一个统一的“蛋白质生物学世界模型”来连接这些任务。它是一个由 Biohub 推出的开源蛋白质建模系统与工具包,包含 ESMC、ESMFold2 和 ESM Atlas,可以帮助开发者从氨基酸序列出发,完成表示、映射、预测和设计蛋白质,覆盖从原子相互作用到数十亿年进化关系的多个尺度。本文将带你全面了解这个潜力新星。
截至收录:
Biohub ESM项目stars数:2960
Biohub ESM项目forks数:388
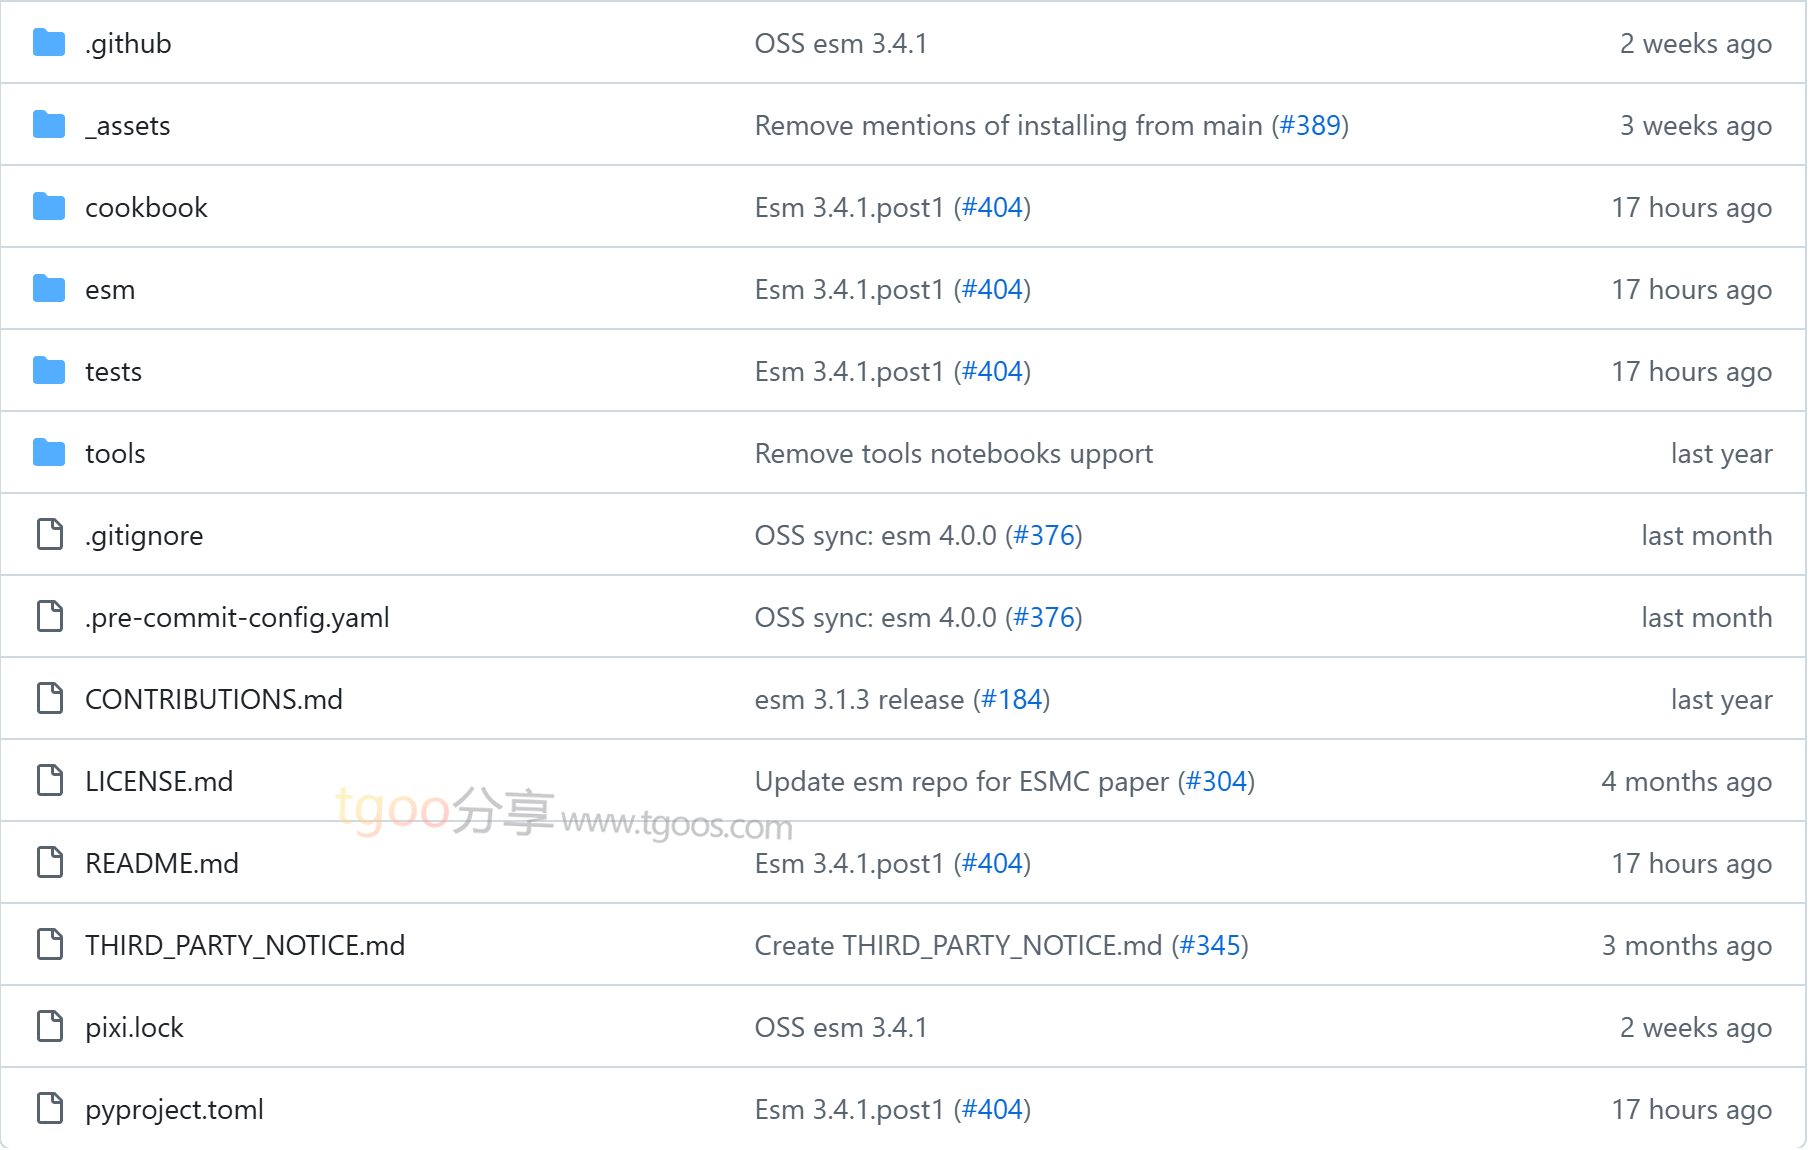
Biohub ESM项目目录截图
Biohub ESM项目核心亮点
- 🌟 从原子到进化尺度的世界模型:ESMC 是在数十亿条蛋白质序列上训练的新一代蛋白质语言模型,能够学习蛋白质生物学的底层规则,并在模型规模扩大时展现出更强的长程结构理解能力。
- 🎯 最先进的结构预测与复合物建模:ESMFold2 基于 ESMC 6B 模型与扩散式结构预测架构,可直接从氨基酸序列预测高分辨率全原子 3D 结构,并支持 MSA、DNA、配体和修饰输入。它在 Foldbench 蛋白-蛋白与抗体-抗原复合物的 DockQ 通过率上表现领先,单序列模式还可带来一个数量级的折叠加速。
- 🧬 可解释的蛋白质功能特征:项目提供基于 ESMC 的稀疏自编码器(SAE),可将模型内部表示分解为约 16,000 个可解释特征,并通过自然语言与已知生物学数据库对齐,帮助研究者理解蛋白质之间的功能关系。
- 🌍 十亿级蛋白质图谱:ESM Atlas 覆盖 68 亿个蛋白质,包含超过 10 亿个预测结构,按照 ESMC 的内部世界模型组织,适合进行大规模蛋白家族挖掘、进化关系分析和功能发现。
- 🚀 生产与生态双通道:
esmv3.4.post1 已发布到 PyPI,支持 ESMC 和 ESMFold2 的生产推理;同时 ESMC 与 ESMFold2 已进入 Hugging Face Transformers v5.16.0+,方便实验、基准测试和现有 ML 工作流集成。模型采用 MIT 许可,并提供 Biohub Platform 与并行执行器。
Biohub ESM项目快速开始
只需几步,你就能在本地运行起 esm:
- 安装:
bash

$ pip install esm - 运行 ESMC 示例:
“`python
import torch
from esm.models.esmc import EsmcForMaskedLM, EsmcTokenizersequence = “MSKGEELFTGVVPILVELDGDVNGHKFSVSGEGEGDATYGKLTLKFICTTGKLPVPWPTLVTTFSYGVQCFSRYPDHMKQHDFFKSAMPEGYVQERTIFFKDDGNYKTRAEVKFEGDTLVNRIELKGIDFKEDGNILGHKLEYNYNSHNVYIMADKQKNGIKVNFKIRHNIEDGSVQLADHYQQNTPIGDGPVLLPDNHYLSTQSALSKDPNEKRDHMVLLEFVTAAGITHGMDELYK”
model = EsmcForMaskedLM.from_pretrained(“biohub/ESMC-6B”, device=”cuda”).eval()
tokenizer = EsmcTokenizer()inputs = tokenizer([sequence], return_tensors=”pt”, padding=True)
inputs = {k: v.to(model.device) for k, v in inputs.items()}with torch.inference_mode():
output = model(**inputs)print(output.logits.shape)
“` - 运行 ESMFold2 示例:
“`python
from esm.models.esmfold2 import (
EsmFold2Model,
ESMFold2InputBuilder,
StructurePredictionInput,
ProteinInput,
)model = EsmFold2Model.from_pretrained(“biohub/ESMFold2″, device=”cuda”).eval()
spi = StructurePredictionInput(
sequences=[
ProteinInput(
id=”A”,
sequence=”MSHHWGYGKHNGPEHWHKDFPIAKGERQSPVDIDTHTAKYDPSLKPLSVSYDQATSLRILNNGHAFNVEFDDSQDKAVLKGGPLDGTYRLIQFHFHWGSLDGQGSEHTVDKKKYAAELHLVHWNTKYGDFGKAVQQPDGLAVLGIFLKVGSAKPGLQKVVDVLDSIKTKGKSADFTNFDPRGLLPESLDYWTYPGSLTTPPLLECVTWIVLKEPISVSSEQVLKFRKLNFNGEGEPEELMVDNWRPAQPLKNRQIKASFK”
)
]
)result = ESMFold2InputBuilder().fold(
model,
spi,
num_loops=20,
num_sampling_steps=100,
num_diffusion_samples=1,
seed=0,
)print(
f”pLDDT mean: {float(result.plddt.mean()):.3f}, ”
f”pTM: {float(result.ptm):.3f}, ipTM: {float(result.iptm):.3f}”
)
“` - 查看更多示例:
bash

# 请参考官方 Tutorials、Biohub Platform 示例和 Hugging Face 模型页

# AMD ROCm 用户建议使用 ROCm 6.4 与 PyTorch 2.9 或更新版本
Biohub ESM项目应用场景
- 场景一:蛋白质结构预测与复合物建模:研究者可以使用 ESMFold2 从单条序列或多序列输入预测蛋白质、蛋白-蛋白复合物、抗体-抗原复合物、DNA/RNA 与配体结合结构,并获得 pLDDT、pTM、ipTM 等置信度指标。
- 场景二:蛋白质与抗体设计:反转 ESMFold2 可生成 de novo minibinders 和抗体来源 scFvs,并在实验验证中表现出高命中率、纳摩尔级亲和力、靶标特异性和功能活性。官方已发布从靶标序列到候选结合体排序的完整 notebook 协议。
- 场景三:功能注释与可解释 AI 分析:借助 ESMC SAE,研究者可以将蛋白质语言模型的内部表示映射到可解释特征,用于功能注释、突变效应分析、蛋白家族关系理解和数据库标注。
- 场景四:大规模蛋白发现与图谱挖掘:ESM Atlas 提供覆盖生命多样性的 68 亿蛋白图谱和超过 10 亿预测结构,适合挖掘新蛋白家族、进化关系和潜在功能靶点。
- 场景五:生产推理与 ML 工作流集成:对生产环境,可使用
esm包获得优化依赖与推理路径;对实验和基准测试,可通过 Hugging Face Transformers 在熟悉的 API 中调用 ESMC 与 ESMFold2,并与现有 ML 生态集成。
用户案例:目前,Biohub 官方通过 Biohub Platform 提供 ESMC、ESMFold2 和 SAE 推理服务;Hugging Face Transformers 自 v5.16.0 起集成 ESMC 与 ESMFold2;研究团队还在预印本中完成了五个治疗靶点的实验验证,并开放了相关代码、权重与设计流程。
Biohub ESM项目链接
- GitHub 仓库:https://github.com/Biohub/esm
- Biohub Platform:https://biohub.ai
- Hugging Face 模型页:https://huggingface.co/biohub
- 预印本:https://www.biorxiv.org/content/10.64898/2026.06.03.729735
- 许可证:MIT LicenseBiohub / esm项目地址:https://github.com/Biohub/esm本文地址:https://www.tgoos.com/46418
